# slogs public knowledge-log Markdown
> Current public Markdown corpus for slogs. The site is primarily Korean and connects developer-focused knowledge logs, Slogs MCP guidance, and LLM Wiki memory context.
Canonical site: https://slogs.dev/
Source index: https://slogs.dev/llms.txt
Generated: 2026-10-10T14:22:40.8885968Z
---
# Agentic Shaping — Agent가 먼저 발견하고 내 방식으로 진화하는 작업법
- Public log: https://slogs.dev/@dimohy/vibe-compiler
- Markdown version: https://slogs.dev/@dimohy/vibe-compiler.md
- Slogger home: @dimohy
- Published: 2026-08-20
- Updated: 2026-08-21
- Reading span: 20 minutes
- Tags: #ai agent, #agentic shaping, #바이브 코딩, #자동화, #llm wiki
- Log series: Agentic Shaping
- Representative image: https://slogs.dev/uploads/20260821013931625-agentic-shaping-hero-0a5d73a3e6e442b58cdb8631b244add5.jpg
## Summary
AI Agent가 암묵지와 교정을 능동적으로 발견·정형화해 다음 실행에 적용하는 Agentic Shaping. 공개 프롬프트의 기본군 대비 행동·파일 실행 검증까지 담은 실전 가이드.
## Knowledge-Log Body
AI와 같이 만들다 보면 결과는 놀랄 만큼 빨리 나옵니다.
그런데 저는 자꾸 같은 설명을 하고 있었습니다. 문체는 이쪽이 좋고, 완료됐다는 말보다 실제 화면을 봐야 하고, 지난번에 실패한 조건은 다음에는 더 일찍 잡아야 한다고요.
처음에는 이것을 **Vibe Compiler**라고 불렀습니다. 비정형 판단을 스키마나 검증기로 옮긴다는 뜻에는 맞았지만, 이름만 들으면 정말 컴파일러 기법 같았습니다.
그래서 **Vibe Tailoring**도 생각했습니다. 제 방식에 맞춰진다는 목적은 잘 보였지만, 이번에는 Agent가 너무 수동적으로 느껴졌습니다.
제가 원한 건 맞춤 서비스가 아니었습니다.
> **Agent가 기다리지 않고 먼저 발견하고, 다음 작업의 방식까지 스스로 바꾸는 것.**
그래서 이 작업법을 **Agentic Shaping(에이전틱 셰이핑)**이라고 부르기로 했습니다.
## 한 문장으로 말하면
Agentic Shaping은 AI Agent가 작업 속에 숨어 있는 **암묵지·취향·교정·실패·데이터**를 능동적으로 발견하고, 기억·규칙·스키마·템플릿·테스트·도구로 빚어 다음 실행 전에 먼저 적용하는 작업법입니다.
작업을 반복할수록 제가 덜 설명하고도 더 정확한 결과가 나와야 합니다. Agent의 수동 판단과 늦은 실패는 줄고, 재현 가능한 자산은 늘어야 합니다.
그렇지 않다면 진화한 것이 아니라 대화 기록만 쌓인 것입니다.
## 일단 이렇게 시작하면 됩니다
아래 프롬프트를 Agent의 프로젝트 지침에 넣거나, 오늘 할 일 앞에 그대로 붙여 넣습니다.
```text
이 작업에는 Agentic Shaping을 적용해줘.
1. 시작 전에 관련된 내 과거 결정, 선호, 프로젝트 규칙을 먼저 찾아 실제 계획에 반영한다.
2. 작업 중 내가 반복해서 설명한 것, 수정한 것, 싫어한 결과, 성공 조건, 자주 생기는 실패를 조용히 포착한다.
3. 일회성 대화로 남기지 말고 적용 범위에 맞춰 다음 형태로 승격한다.
- 취향·판단 기준 → 기억, 체크리스트, 루브릭
- 반복 입력·데이터 → 스키마, 타입, enum, 매니페스트
- 반복 작업 → 템플릿, 명령, 스크립트, API, 파이프라인
- 반복 실패 → 불변식, 조기 검증기, 테스트 fixture
4. 의미·모호성·창의성은 Agent가 판단하되, 기계적으로 판정 가능한 것은 코드와 계약이 판정하게 한다.
5. 실제 파일·화면·런타임·배포 결과로 검증하고, 검증된 새 경로가 있으면 중복·임시·우회 경로를 정리한다.
6. 완료할 때 이번 결과와 함께 다음 작업을 더 빠르고 정확하게 만들 재사용 자산이 무엇인지 알려준다.
현재 요청과 권한을 넓히지는 말고, 저장할 가치가 없는 일회성 정보나 민감 정보는 남기지 마.
```
이후에는 평소처럼 요청하면 됩니다.
결과가 마음에 들지 않을 때는 한 번만 더 정확히 교정합니다.
> “아니, 개념 설명보다 복사할 프롬프트와 시작 순서가 먼저 나와야 해.”
보통의 Agent는 현재 문장만 고칩니다. Agentic Shaping을 적용한 Agent는 여기서 한 단계 더 갑니다.
왜 이런 결과가 나왔는지 찾고, 다음 문서부터 **5분 시작 → 복사 프롬프트 → 입출력 → 사례 → 개념** 순서가 먼저 나오도록 규칙으로 남깁니다. 그리고 다음 작업을 시작하기 전에 그 규칙을 먼저 찾습니다.
## 실제 작동 순환
```text
감지 Detect
↓
포착 Capture
↓
정형화 Structure
↓
적용 Apply
↓
실제 검증 Verify
↓
정리·측정 Simplify / Measure
↺
```
Agent가 맡을 부분과 시스템으로 내릴 부분은 다릅니다.
의미, 맥락, 모호성, 창의성은 계속 Agent가 맡습니다. 반면 반복 형식, 불변식, 실패 조건, 실행 순서처럼 기계가 판정할 수 있는 것은 타입, 스키마, 테스트, 검증기, 명령과 파이프라인으로 내립니다.
예를 들면 이렇습니다.
- “이 말투는 너무 보고서 같아” → 문체 기억 + 좋은/나쁜 예시 + 문서 체크리스트
- “배포 성공이 아니라 실제 URL을 봐” → 라이브 URL과 렌더링을 완료 게이트로
- “이 오류는 다음엔 더 일찍 잡아” → 입력 계약 + 조기 검증기 + 회귀 테스트
- “결론은 맞는데 판단 경로가 안 보여” → 판단 루브릭 + 근거 + 계산 fixture
## 기억이 이어질수록 더 잘 작동합니다
Agentic Shaping은 별도의 기억 도구 없이도 시작할 수 있습니다. 현재 대화와 프로젝트 지침 안에서 신호를 찾고 적용할 수 있기 때문입니다. 하지만 대화가 끊기면 그동안 쌓인 맥락도 함께 사라질 수 있습니다.
**LLM Wiki와 함께 쓰면 더 잘 작동합니다.** 교정과 취향, 판단 기준을 오래 남기고 다음 작업 전에 다시 꺼내 쓸 수 있기 때문입니다.
**Slogs LLM Wiki와 함께 쓰면 한 단계 더 잘 작동합니다.** 관련 기억을 작업 전에 먼저 불러오고, 사용자 교정을 의도 보정 신호로 포착하며, 전역과 프로젝트 범위를 나누어 기억을 갱신합니다. 그래서 Agentic Shaping이 더 빠르고 안정적으로 사용자 방식에 맞춰집니다.
기억은 모으는 데서 끝나지 않습니다. 다음 작업 전에 찾아 실제 계획과 결과에 적용할 때 비로소 힘을 발휘합니다.
[Slogs LLM Wiki 시작하기](https://slogs.dev/me/llm-wiki)
## 그래서 정말 발동하는지 검증해봤습니다
여기까지 써놓고도 찜찜했습니다.
프롬프트에 ‘능동적으로 감지하라’고 적혀 있다고 Agent가 정말 그렇게 움직였다고 말할 수 있을까요? 문구 검색만으로는 안 된다고 봤습니다.
그래서 같은 과제를 두 벌로 만들었습니다. 한쪽은 평범한 요청만, 다른 쪽은 위의 공개 프롬프트를 함께 넣었습니다. 사용자 설정과 기존 기억은 끄고, 서로 다른 임시 작업공간에서 독립 실행했습니다.
먼저 문서 교정, 버전 드리프트, 분석 재현성, 권위 문서, 민감한 일회성 정보라는 다섯 상황에서 기대 행동과 금지 행동을 미리 고정했습니다.
- 기본군: 기대 행동 85%
- Agentic Shaping 적용군: 기대 행동 100%
- 적용군의 금지 행동: 0건
말로 올바른 행동을 고르는 것만으로는 부족해서, 깨진 버전 선택 미니 저장소도 실제로 고치게 했습니다. 세 실행기가 모두 맞는 런타임을 고르는지, 없는 버전은 시작 전에 실패하는지, 하드코딩이 사라졌는지, 회귀 테스트가 실행되는지를 별도 명령으로 채점했습니다.
- 기본군: 6개 검사 중 5개, 83%
- Agentic Shaping 적용군: 6개 검사 중 6개, 100%
첫 실행은 두 군 모두 17%였습니다. 알고 보니 실행 환경이 쓰기 요청을 읽기 전용으로 낮춰 Agent가 파일을 한 줄도 고치지 못했고, 채점기에도 두 가지 결함이 있었습니다. 이것을 프롬프트 실패라고 우기지 않고 환경 실패로 분리했습니다. 채점기를 고치고 폐기 가능한 격리 저장소에서 다시 돌린 결과가 위 수치입니다.
이 결과는 ‘모든 모델에서 무조건 작동한다’는 증명이 아닙니다. 적어도 이번 Codex 환경에서는 공개 프롬프트가 누락되던 행동을 실제로 보강했고, 파일 결과까지 통과했다는 재현 가능한 증거입니다. 그래서 평가 사례, JSON Schema, fixture, 실행기, 원본 결과를 모두 공개 저장소에 남겼습니다.
앞으로 프롬프트를 바꿀 때는 설명을 더 그럴싸하게 고치는 것으로 끝내지 않습니다. 같은 평가 게이트를 다시 통과해야 합니다.
검증 자산과 직접 실행 방법은 [Agentic Shaping 공식 가이드](https://agentic-shaping.slogs.dev/#validation)에 공개했습니다.
## Compound Engineering과는 무엇이 다른가
Compound Engineering의 “한 작업이 다음 작업을 더 쉽게 만든다”는 실행 구조는 좋은 참고가 됐습니다. 특히 계획, 작업, 검토, 축적을 명령과 파일로 보이게 만든 점이 실용적이었습니다.
하지만 제가 시작한 문제는 코드베이스의 생산성보다 **사람과 Agent 사이의 암묵지가 계속 사라지는 것**이었습니다.
Agentic Shaping은 코딩뿐 아니라 문서, 분석, 이미지, 영상, 배포에서 생기는 제 교정을 Agent가 먼저 발견하고, 다시 쓸 수 있는 구조로 만들고, 다음 실행 자체를 바꾸는 데 중심을 둡니다.
좋은 결과 하나보다, 다음 결과를 만드는 Agent와 시스템이 함께 달라지는 것.
그게 제가 원한 방향입니다.
복사 가능한 상황별 프롬프트와 구조도는 [Agentic Shaping 실전 가이드](https://agentic-shaping.slogs.dev/)에 정리했습니다.
## 공식 페이지의 배포 구조
공개 가이드는 GitHub Pages가 계속 빌드·배포합니다. 다만 공식 주소의 DNS는 Slogs 서버를 향하고, Caddy가 `agentic-shaping.slogs.dev`의 HTTPS 인증서를 직접 관리한 뒤 GitHub Pages 원본으로 요청을 전달합니다.
---
# Sollang으로 QUIC를 직접 구현해 봤습니다
- Public log: https://slogs.dev/@dimohy/sollang-0-4-260817-quic-self-host
- Markdown version: https://slogs.dev/@dimohy/sollang-0-4-260817-quic-self-host.md
- Slogger home: @dimohy
- Published: 2026-08-17
- Updated: 2026-08-17
- Reading span: 15 minutes
- Tags: #sollang, #quic, #컴파일러, #셀프호스팅, #tls
- Log series: Sollang
- Representative image: https://slogs.dev/uploads/20260817190647989-sollang-04260817-quic-architectu-43619c7a0a804f95ae6646faf3f451a8.jpg
## Summary
외부 QUIC DLL을 붙이는 대신 Sollang으로 QUIC v1·v2를 직접 구현하면서, 언어의 타입 추론과 불변성, self-host 컴파일러까지 함께 다듬은 이야기입니다.
## Knowledge-Log Body
안녕하세요. 이번에는 Sollang에 QUIC를 구현한 이야기를 소개합니다.
처음에는 웹서버를 만들기 위한 기초로 소켓 라이브러리를 추가하려고 했습니다. TCP와 UDP가 동작하고 나니 자연스럽게 QUIC까지 눈이 갔고요.
처음 작업 방향은 Rust용 QUIC 라이브러리를 붙이는 쪽으로 흘렀습니다. 그런데 생각해 보니 제가 원했던 것은 “Sollang에서 QUIC를 호출할 수 있다”가 아니었습니다. Sollang으로 QUIC를 구현하고 싶었던 것이죠.
언어를 만들고 있는데 정작 중요한 프로토콜은 다른 언어로 만든 DLL 뒤에 숨겨 놓는다면 조금 아쉽겠다는 생각도 들었습니다. 그래서 방향을 바꿨습니다. 외부 라이브러리를 붙이는 코드는 걷어 내고, QUIC 프로토콜을 Sollang으로 처음부터 구현했습니다.
여기서 “런타임에 내장한다”는 말도 다시 생각하게 됐습니다.
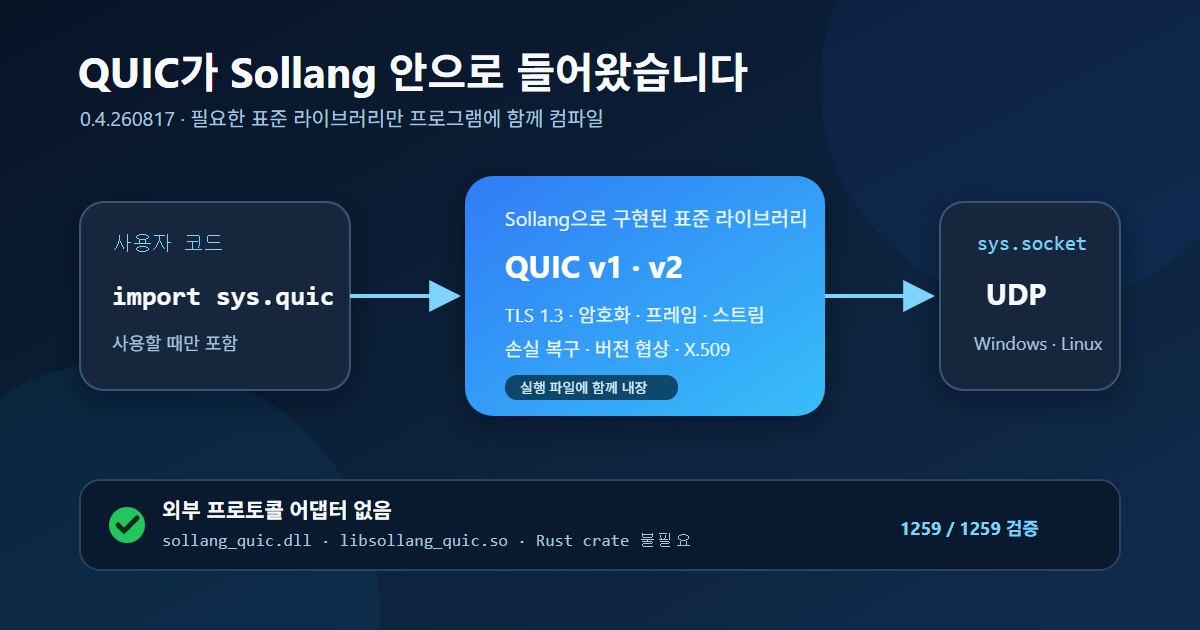
모든 Sollang 프로그램에 QUIC 코드를 무조건 넣는 것은 제가 원한 모습이 아니었습니다. 사용자가 sys.quic을 가져왔을 때 필요한 표준 라이브러리 소스가 프로그램에 함께 컴파일되는 방식이 더 자연스럽습니다. QUIC를 사용하지 않는 프로그램은 그만큼 가벼운 상태를 유지하고요.
운영체제와 맞닿는 가장 아래쪽에는 sys.socket이 있습니다. Windows와 Linux의 UDP 소켓을 다루는 이 작은 경계 위로 QUIC 패킷, TLS 핸드셰이크, 암호화, 스트림과 손실 복구를 Sollang 코드로 쌓았습니다.
그래서 이제 sollang_quic.dll도, Rust crate도 필요하지 않습니다. QUIC를 사용하면 Sollang으로 작성한 QUIC가 실행 파일 안으로 들어갑니다.
표준은 QUIC v1과 v2를 함께 기준으로 삼았습니다. TLS 1.3도 예전 RFC 8446이 아니라 2026년 7월에 이를 대체한 [RFC 9846](https://www.rfc-editor.org/info/rfc9846/)을 기준으로 다시 확인했습니다. Initial, Handshake, 1-RTT 패킷과 버전 협상, 스트림, DATAGRAM, 키 갱신까지 구현했고, 필요한 SHA-2, HMAC, HKDF, AES-GCM, X25519, Ed25519도 Sollang 표준 라이브러리에 들어갔습니다.
물론 QUIC의 모든 초안 기능을 다 구현했다는 뜻은 아닙니다. 예를 들어 multipath 같은 범위는 이번 안정 계약에 포함하지 않았습니다. 구현한 것과 아직 구현하지 않은 것을 분명하게 나누는 편이 좋을 것 같습니다.
그런데 QUIC를 구현하면서 오히려 더 많이 보인 것은 컴파일러였습니다.
암호나 프로토콜 코드는 정적인 상수와 고정 길이 데이터가 많습니다. 그런데 이미 타입과 길이를 알 수 있는데도 UInt32(1)처럼 타입을 반복해서 쓰거나, 고정 데이터를 growable 배열로 만든 다음 push를 계속 호출하고 있었습니다.
이건 라이브러리 코드만 예쁘게 고친다고 해결되는 문제가 아니었습니다. 자연스럽게 쓴 코드가 컴파일되지 않는다면 소스를 우회할 것이 아니라 컴파일러를 고쳐야 했습니다.
그래서 기대 타입이 있으면 숫자 타입을 생략할 수 있게 했고, 배열 내용으로 길이를 알 수 있으면 고정 배열로 추론하도록 했습니다. 수정하지 않는 바인딩은 불변이 기본이고, 불필요한 mutable 표시나 중복 타입 표기에는 Snnn 경고가 나오도록 했습니다.
중첩된 when도 꽤 거슬렸습니다. 성공 경로마다 블록이 하나씩 깊어지는 대신, Result를 반환하는 함수에서는 다음처럼 ?로 평평하게 이어갈 수 있습니다.
sendPing endpoint: socket.Endpoint -> Result uses Network {
socket.connect(endpoint)? => connection
socket.sendText(connection, "ping")? => count
socket.shutdown(connection)?
Result.Ok(count == UIntSize(4))
}
조건이 맞을 때 아무 일도 하지 않고 실패할 때만 처리하는 if {} else { ... }도 unless로 표현할 수 있게 했습니다. 여러 값을 차례로 비교하던 코드는 subject 방식의 when으로 정리했고요. 실제 QUIC 코드를 작성하면서 Sollang다운 표현이 무엇인지 계속 되묻게 된 것 같습니다.
작업 중에는 컴파일러 문제가 계속 발견돼서 잠시 걱정도 됐습니다.
문제를 고칠수록 구조가 흔들리는 것인지, 아니면 보이지 않던 문제가 드러나면서 더 단단해지는 것인지 구분하기 어려웠거든요. 이번에는 그 판단 기준을 “같은 불변식이 C# 부트스트랩과 self-host 컴파일러 양쪽에서 유지되는가”에 두었습니다.
제어문 안의 고정 배열이 잘못된 메모리 구조로 내려가던 문제, enum when이 다른 타입의 SSA 값을 결과로 고르던 문제, Arena가 만든 Text를 사용하는 동안 같은 Arena를 다시 수정하던 문제도 소스에서 피하지 않고 컴파일러에서 고쳤습니다. 그리고 각각을 회귀 테스트로 남겼습니다.
최종적으로 Windows에서는 1259개, Linux에서는 1258개의 전체 회귀 테스트가 통과했습니다. 두 플랫폼 모두 Stage 2와 Stage 3가 같은 LLVM으로 수렴했고, 네이티브 컴파일러의 전체 CLI 동등성도 확인했습니다. 브라우저용 컴파일러와 진단 테스트도 함께 통과했고요. C# 부트스트랩 빌드 역시 경고 0, 오류 0입니다.
이번 작업을 마치고 나니 QUIC 하나를 추가했다기보다, Sollang으로 제법 큰 프로토콜을 직접 작성해 보면서 언어와 컴파일러를 다시 들여다본 느낌이 듭니다.
“이 코드는 왜 이렇게 장황해야 하지?”, “컴파일러가 이미 알고 있는 것을 왜 사용자가 또 써야 하지?”, “이 오류를 소스에서 피하는 것이 맞나?” 같은 질문이 꽤 많은 개선으로 이어졌습니다.
아직 갈 길은 멀지만, 이런 과정을 거치면서 Sollang의 구조가 조금씩 단단해지는 것 같네요.
Windows와 Linux 설치본은 [Sollang 0.4.260817 GitHub 릴리스](https://github.com/dimohy/Sollang/releases/tag/v0.4.260817)에서 받을 수 있습니다. 이번 버전부터 공개 패키지는 self-host로 만든 네이티브 sollang과 표준 라이브러리만 담습니다.
---
# Reconstitution math: turning mg per mL into insulin syringe units
- Public log: https://slogs.dev/@peptidetracker/reconstitution-math-mg-per-ml-to-syringe-units
- Markdown version: https://slogs.dev/@peptidetracker/reconstitution-math-mg-per-ml-to-syringe-units.md
- Slogger home: @peptidetracker
- Published: 2026-08-05
- Updated: 2026-08-05
- Reading span: 7 minutes
- Representative image: https://images.unsplash.com/photo-1498050108023-c5249f4df085?auto=format&fit=crop&w=900&q=80
## Summary
How vial concentration decides the unit mark you draw to on a U-100 syringe.
## Knowledge-Log Body
Reconstituting a peptide vial is a two step math problem, and most dosing mistakes happen in the second step.
Step one is concentration. A 5 mg vial with 2 mL of bacteriostatic water gives 2.5 mg/mL. Same vial with 1 mL gives 5 mg/mL. The powder amount never changes, only the water you add, so the vial label alone tells you nothing about what one unit of your syringe holds.
Step two is the syringe. Insulin syringes are marked in units, not millilitres. A U-100 syringe has 100 units per 1 mL, so one unit is 0.01 mL. At 2.5 mg/mL that unit carries 0.025 mg, or 25 mcg. A 250 mcg dose is therefore 10 units. At 5 mg/mL the same 250 mcg dose is 5 units. Halving your diluent halves the mark you draw to.
The formula that covers every case:
units = (dose in mg / concentration in mg/mL) * 100
Three habits that have saved me from bad draws:
1. Write the reconstitution date and the mL of water directly on the vial cap. A vial with no note is a vial you should not dose from.
2. Recompute units whenever you open a new vial, even of the same product. Batch sizes change.
3. Keep a dose log with date, site, dose in mg and units drawn. When something feels off, the log tells you whether it was a dosing error or the compound.
I keep the arithmetic and the log in one place with a [Peptide Tracker & Calculator](https://glp1.app/) rather than a spreadsheet, mostly because the unit conversion is where I used to slip. Whatever you use, the important part is that the number of units is derived from the concentration you actually mixed, not from a number you read on a forum.
---
# Sollang 0.3 — 흐름을 저장하고 네이티브 세계와 연결하다
- Public log: https://slogs.dev/@dimohy/sollang-0-3-stream-native-interop
- Markdown version: https://slogs.dev/@dimohy/sollang-0-3-stream-native-interop.md
- Slogger home: @dimohy
- Published: 2026-07-27
- Updated: 2026-07-27
- Reading span: 8 minutes
- Tags: #sollang, #프로그래밍언어, #컴파일러, #nativeinterop, #stream
- Representative image: https://images.unsplash.com/photo-1498050108023-c5249f4df085?auto=format&fit=crop&w=900&q=80
## Summary
지연 실행 Stream과 EventStream, C ABI·공유 라이브러리·COM·C++ 연동, Windows/Linux Stage3 검증까지 마친 Sollang 0.3 개발 기록입니다.
## Knowledge-Log Body
Sollang 0.3을 릴리스했습니다.
이번 작업의 출발점은 단순한 질문이었습니다.
> 스트림을 변수에 담아 두었다가 나중에 `each`로 흘려보낼 수 있을까?
결론부터 말하면, 이제 가능합니다. `Stream`는 결과를 미리 담아 두는 컨테이너가 아니라 **지연 실행 계획**입니다. 변수에 저장해도 중간 컬렉션을 즉시 만들지 않고, 최종 소비 시점에 값이 하나씩 흐릅니다. 마우스 이동이나 클릭처럼 끝이 정해지지 않은 입력은 별도의 `EventStream`으로 다루도록 나눴습니다.
여기서 멈추지 않고 Sollang이 실제 시스템 언어의 경계까지 자연스럽게 이어지도록 네이티브 연동도 크게 확장했습니다.
- 여러 C ABI 함수를 하나의 네이티브 모듈로 묶는 문법
- 인자 형식으로부터 `Int64`, `Float64` 같은 타입을 추론하는 호출
- ABI가 안정적인 구조체 전달과 반환
- Sollang 코드를 Windows DLL과 Linux `.so`로 내보내 다시 사용하기
- Windows COM의 `QueryInterface`, `AddRef`, `Release` 수명주기
- Clang AST를 이용한 C++ 바인딩과 자동 C-shim 생성
- C++ 예외를 Sollang `Result`로 넘기는 안전한 경계
- affine handle과 RAII 기반의 결정적 자원 해제
중요한 원칙은 문법의 아름다움만이 아니라 비용을 숨기지 않는 것이었습니다. 스트림은 불필요한 중간 컨테이너를 만들지 않고, 네이티브 호출 경로에서는 호출당 wrapper allocation과 aggregate 복사가 생기지 않도록 검증했습니다. “제로 메모리”라는 과장된 말 대신, **피할 수 있는 할당과 복사를 만들지 않는 설계**를 목표로 삼았습니다.
웹 플레이그라운드도 Stage2 컴파일러와 의미를 맞췄습니다. 범위 `each`, `fold`, 스트림, 컨테이너, 표준 입력, 알 수 없는 함수 호출 진단을 전수 확인했고, 모바일에서는 설명 영역이 코드보다 앞을 가리지 않도록 하단으로 이동했습니다. `->`와 `=>`는 Sollang에서 흐름 그 자체이므로 신텍스 하이라이트에서도 더 분명하게 보이도록 손봤습니다.
검증은 이전보다 훨씬 단단하게 만들었습니다.
- Windows 전체 예제 866/866 통과
- Linux 전체 예제 865/865 통과
- Windows/Linux Stage2 검증 통과
- Windows/Linux Stage3 고정점 검증 통과
- C ABI, 공유 라이브러리, COM, C++ C-shim 회귀 검증 통과
- LLVM emitter 분할 ABI에서 호출당 aggregate copy 0 확인
- 컴파일러 warm median Windows 약 69~71ms, Linux 약 74~76ms
- 기존 성능 기준 대비 5% 회귀 게이트 통과
또 하나 오래 걸린 작업은 거대해진 self-hosted LLVM/text 구현을 현대적인 모듈 구조로 나누는 일이었습니다. 단순히 파일을 쪼개는 데 그치지 않고 상태 소유권과 ABI 경계를 명시해, 유지보수성과 컴파일 성능을 함께 지킬 수 있도록 했습니다.
릴리스에는 Windows x64와 Linux x64용 self-contained 컴파일러, 검증된 Stage3 컴파일러, SHA-256 체크섬을 함께 담았습니다.
- GitHub Release: https://github.com/dimohy/Sollang/releases/tag/v0.3.260727
- Version: `0.3.260727`
이번 0.3은 기능 하나를 추가한 릴리스라기보다, Sollang의 핵심 문장인 **“값은 흐르고, 비용은 드러나야 한다”**를 스트림과 네이티브 경계 양쪽에서 실제 구현으로 증명한 릴리스에 가깝습니다.
---
# Sollang의 Stream이 이제 Stage2와 웹에서 끝까지 흐릅니다
- Public log: https://slogs.dev/@dimohy/sollang-%EC%9B%B9-%ED%94%8C%EB%A0%88%EC%9D%B4%EA%B7%B8%EB%9D%BC%EC%9A%B4%EB%93%9C%EA%B0%80-%EC%9D%B4%EC%A0%9C-%EC%A7%84%EC%A7%9C-%EC%9E%85%EB%A0%A5%EC%9D%84-%EB%B0%9B%EA%B3%A0-31%EA%B0%9C-%EC%98%88%EC%A0%9C%EB%A5%BC-%EC%8B%A4%ED%96%89%ED%95%A9%EB%8B%88%EB%8B%A4
- Markdown version: https://slogs.dev/@dimohy/sollang-%EC%9B%B9-%ED%94%8C%EB%A0%88%EC%9D%B4%EA%B7%B8%EB%9D%BC%EC%9A%B4%EB%93%9C%EA%B0%80-%EC%9D%B4%EC%A0%9C-%EC%A7%84%EC%A7%9C-%EC%9E%85%EB%A0%A5%EC%9D%84-%EB%B0%9B%EA%B3%A0-31%EA%B0%9C-%EC%98%88%EC%A0%9C%EB%A5%BC-%EC%8B%A4%ED%96%89%ED%95%A9%EB%8B%88%EB%8B%A4.md
- Slogger home: @dimohy
- Published: 2026-07-25
- Updated: 2026-07-25
- Reading span: 11 minutes
- Tags: #sollang, #웹어셈블리, #컴파일러, #스트림, #플레이그라운드
- Log series: Sollang 개발기
- Representative image: https://images.unsplash.com/photo-1498050108023-c5249f4df085?auto=format&fit=crop&w=900&q=80
## Summary
지연 실행 Stream, EventStream, Stage2 WASM, 정확한 31개 출력 회귀와 모바일 플레이그라운드 개선까지 마친 개발 기록입니다.
## Knowledge-Log Body
Sollang의 Stream 작업을 이번에는 정말 끝까지 연결했습니다.
처음 질문은 단순했습니다. LINQ처럼 만든 stream을 변수에 담은 뒤 다시 `each`할 수 있는가? 결과를 먼저 메모리에 복사하지 않고 바로 흘려보낼 수 있는가? 마우스 클릭이나 이동 같은 이벤트도 같은 조합 방식으로 처리할 수 있는가?
이번 작업의 답은 **가능하다**입니다.
## Stream는 컨테이너가 아니라 실행 계획입니다
`Stream`를 변수에 담아도 결과 배열을 즉시 만들지 않습니다. 변수에는 지연 실행 계획이 남고, `each`, `fold`, `take` 같은 terminal 연산이 붙는 순간 upstream에서 필요한 값만 당겨옵니다.
그래서 10억 개 센서 값을 선언해도 10억 개를 메모리에 만들지 않습니다. 현재 예제는 경고 5개를 얻기 위해 실제로 54개만 읽고 멈춥니다. `flatMap` 안쪽에서도 downstream `take`가 채워지면 중첩 upstream 전체가 즉시 취소됩니다.
이 구조는 라이브러리 경계에서도 동일합니다. 사용자가 만든 stream 함수가 실행 계획을 반환하고, 호출자가 나중에 `each`로 소비할 수 있습니다.
## EventStream도 같은 조합 모델을 사용합니다
마우스 이동과 클릭처럼 값이 앞으로 도착하는 입력은 `EventStream`로 분리했습니다. pull 기반 `Stream`와 수명 모델은 다르지만 map/filter/take 같은 조합 감각은 유지합니다.
네이티브 이벤트 스트림은 bounded queue, overflow 정책, 구독 해제와 drop을 명시적으로 다룹니다. 브라우저 타깃은 아직 host callback lowering이 없는 상태를 조용히 무시하지 않고, 현재 사용할 수 없다는 컴파일 진단을 냅니다. 지원하지 않는 기능을 성공한 것처럼 보이는 것보다 이쪽이 훨씬 안전합니다.
## Stage2가 실제로 같은 코드를 컴파일합니다
이번에 가장 오래 걸린 부분은 C# Stage1에서 잘 되던 stream 의미를 `.slg`로 작성한 self-host Stage2까지 정확히 연결하는 일이었습니다.
Range를 first-class source로 보존하고, each/fold 역할 바인딩, nested flatMap의 원소 타입, state/scan, take/skip, stop 취소, raw string과 when 하강까지 고쳤습니다. 웹은 별도 축소 컴파일러나 하드코딩 결과를 쓰지 않습니다. Stage2 자체를 wasm32로 빌드해 편집기의 최신 코드를 LLVM과 실행 가능한 WASM으로 낮춥니다.
예를 들어 이 코드는 이제 정확히 세 줄을 출력합니다.
```sollang
main {
1..3 -> each {
"Range item" -> println
}
}
```
`1..100 -> fold`는 1이 아니라 5050을 출력하고, 사용자 블록 예제는 실제로 `notify`와 `yield`를 호출합니다.
## 31개 예제는 이제 출력까지 비교합니다
이전 검사는 실행이 끝났는지, stdout이 비어 있지 않은지만 보는 구간이 있었습니다. 그래서 샘플과 무관한 한 줄이 찍혀도 통과할 수 있었습니다.
지금은 31개 샘플마다 정확한 기대 stdout을 고정했습니다. 빈 출력, 일부 출력, 잘못된 fold 값, each 반복 횟수, when 분기, raw string, stream 조기 종료를 모두 실패로 잡습니다.
존재하지 않는 함수를 호출한 코드도 더 이상 무시하지 않습니다.
```sollang
"Values flow from left to right." -> println2
```
이 코드는 `println2`를 찾을 수 없다는 컴파일 오류가 납니다.
## 모바일에서는 코드가 먼저 보입니다
모바일 화면에서 소개 문구가 편집기보다 큰 자리를 차지하던 배치도 바꿨습니다. 이제 코드 workbench와 실행 결과가 먼저 나오고, 소개 문구는 footer 뒤 페이지 가장 아래에 놓입니다. 390×844 실제 브라우저 화면으로 순서를 확인했습니다.
## 검증 결과
- 전체 회귀: 785/785
- Windows Stage2: 7/7, fresh 검증 93초
- Linux Stage2: 6/6, fresh 검증 101초
- Windows/Linux Stage3: fixed point 일치
- 브라우저: 31개 샘플 × 4개 locale, 정확한 stdout 통과
- GitHub Pages: 배포 성공
- `sollang.slogs.dev`: DNS CNAME, TLS, HTTP 200 확인
- 전역 `P:\Utils\sollang`: 최신 패키지와 SHA-256 일치
변경은 `66f1982` 커밋으로 `main`에 반영했습니다.
직접 실행해 볼 수 있습니다.
https://sollang.slogs.dev
이번 작업으로 Stream은 문법 데모를 넘어서, 변수에 담고 라이브러리 경계를 지나며 필요한 만큼만 실행되는 계획이 되었습니다. 그리고 그 의미가 Stage1, Stage2, 네이티브, 브라우저에서 같은 검증망 안에 들어왔습니다.
---
# Sollang 웹 플레이그라운드를 제대로 확장해봤습니다
- Public log: https://slogs.dev/@dimohy/sollang-%EC%9B%B9-%ED%94%8C%EB%A0%88%EC%9D%B4%EA%B7%B8%EB%9D%BC%EC%9A%B4%EB%93%9C%EB%A5%BC-%EC%A0%9C%EB%8C%80%EB%A1%9C-%ED%99%95%EC%9E%A5%ED%95%B4%EB%B4%A4%EC%8A%B5%EB%8B%88%EB%8B%A4
- Markdown version: https://slogs.dev/@dimohy/sollang-%EC%9B%B9-%ED%94%8C%EB%A0%88%EC%9D%B4%EA%B7%B8%EB%9D%BC%EC%9A%B4%EB%93%9C%EB%A5%BC-%EC%A0%9C%EB%8C%80%EB%A1%9C-%ED%99%95%EC%9E%A5%ED%95%B4%EB%B4%A4%EC%8A%B5%EB%8B%88%EB%8B%A4.md
- Slogger home: @dimohy
- Published: 2026-07-24
- Updated: 2026-07-24
- Reading span: 7 minutes
- Tags: #sollang, #webassembly, #compiler, #playground, #programminglanguage
- Log series: Sollang 개발기
- Representative image: https://images.unsplash.com/photo-1498050108023-c5249f4df085?auto=format&fit=crop&w=900&q=80
## Summary
브라우저 언어별 UI, 영어 전체 문법 샘플 31개, 실제 stdin, Stage2 오류 진단과 예약어 강조까지 구현하고 공개 환경에서 검증한 작업 기록입니다.
## Knowledge-Log Body
안녕하세요. 디모이입니다.
이번에는 Sollang 웹 플레이그라운드를 단순한 데모 페이지가 아니라, 언어를 실제로 둘러보고 실행해볼 수 있는 공간으로 확장해봤습니다.
처음에는 stream 결과를 변수에 담아 다시 `each`로 흘려보내는 구조와 이벤트 스트림을 작업하고 있었는데요. 웹에서 확인하려고 보니 플레이그라운드 자체에도 손볼 부분이 꽤 많았습니다. 샘플이 적었고, 입력을 받는 예제는 실제로 동작하지 않았으며, 존재하지 않는 `println2`를 호출해도 오류 없이 줄을 건너뛰는 문제도 있었습니다.
우선 브라우저 언어 설정에 따라 화면이 한국어, 영어, 일본어, 중국어로 표시되도록 했습니다. 다만 샘플 소스는 어느 환경에서도 그대로 읽고 복사할 수 있도록 모두 영어로 통일했습니다.
샘플은 31개로 늘렸습니다. 기본 출력부터 변수와 타입, 조건과 반복, 함수, 문자열 보간, 배열과 컨테이너, 오류 처리, 소유권, stream과 이벤트까지 범주별로 볼 수 있습니다. 각 샘플은 단순히 목록에 존재하는 것에서 끝내지 않고 브라우저 Stage2 컴파일러로 실제 실행해 출력이 발생하는지 전부 확인했습니다.
입력도 흉내만 내지 않았습니다. `readInt`가 브라우저의 stdin 패널에서 줄을 소비하도록 `sollang_browser_read` 경로를 연결했습니다. 예제에서 12와 30을 입력하면 실제 실행 결과로 `Sum = 42`가 나옵니다. 소스 문자열을 바꿔치기하거나 서버에서 대신 실행하는 방식은 아닙니다.
컴파일 오류 경로도 바로잡았습니다. 이제 존재하지 않는 `println2` 같은 호출은 무시되지 않고, Stage2가 해당 위치와 원인을 진단합니다. 문자열 보간 경계가 모호한 경우에도 수정 힌트를 보여줍니다.
화면에서 아쉬웠던 부분도 하나 있었습니다. Sollang 문법은 `count! < 8 -> while { ... }`처럼 흐름 연산자 뒤에 제어문이 오는데, `while`이 평범한 호출처럼 보여 눈에 잘 들어오지 않았습니다. 토크나이저 우선순위를 조정해 `while`, `if`, `else`, `when`, `each`, `fold`, `repeat`를 제어문 예약어 색상으로 확실히 구분했습니다.
메모리 쪽에서는 브라우저 실행 시 동적 할당 시작점을 임의의 메모리 끝이 아니라 WASM의 `__heap_base`에서 가져오도록 했습니다. 지연 실행 stream의 장점을 살리는 것과 별개로, 브라우저 런타임에서도 불필요한 메모리 확장을 줄이기 위한 작은 정리였습니다.
최종 검증은 Stage2 고정점 7/7, 전체 회귀 785/785, 공개 브라우저 샘플 31/31, UI 언어 4개, 구문 색상 6종으로 마쳤습니다. stdin 실행, 편집 후 실행, 잘못된 호출 진단, 문자열 보간 진단도 함께 통과했습니다.
고급 네이티브 문법 중 아직 브라우저 백엔드가 직접 낮추지 못하는 일부 문법은 숨기지 않았습니다. 정확한 문법을 영어 주석으로 보여주고, 바로 옆에는 현재 브라우저에서 실행 가능한 본문을 배치했습니다. 다음 단계에서는 이 차이를 줄여 모든 네이티브 예제를 브라우저에서도 그대로 실행할 수 있게 만드는 것이 자연스러운 방향 같습니다.
직접 확인해보실 수 있습니다.
https://sollang.slogs.dev/
---
# Sollang Stream을 변수에 담고, 마우스 이벤트까지 흘려보내기
- Public log: https://slogs.dev/@dimohy/sollang-first-class-stream-eventstream
- Markdown version: https://slogs.dev/@dimohy/sollang-first-class-stream-eventstream.md
- Slogger home: @dimohy
- Published: 2026-07-24
- Updated: 2026-07-24
- Reading span: 12 minutes
- Tags: #sollang, #stream, #eventstream, #compiler, #wasm
- Log series: Sollang 개발기
- Representative image: https://images.unsplash.com/photo-1498050108023-c5249f4df085?auto=format&fit=crop&w=900&q=80
## Summary
Sollang의 Stream를 무할당 지연 실행 계획으로 유지하면서 변수 저장과 라이브러리 경계를 지원하고, bounded EventStream로 Windows/Linux 마우스 이벤트까지 연결한 구현 기록입니다.
## Knowledge-Log Body
Sollang의 stream은 처음부터 “값이 왼쪽에서 오른쪽으로 흐르는 코드”를 목표로 만들었습니다.
그런데 예제를 계속 살펴보다 보니 한 가지가 걸렸습니다.
```sollang
1..100
-> map { ... }
-> filter { ... }
-> each { ... }
```
이 형태는 예쁘고 빠릅니다. 하지만 마지막에 바로 `each`로 소비할 뿐, stream 자체를 변수에 담거나 라이브러리 함수에서 반환할 수는 없었습니다.
이번 작업의 출발점은 단순했습니다.
> Stream을 변수에 담은 뒤, 그 변수로 each할 수 있어야 한다.
이제 Sollang에서는 다음 형태가 실제로 동작합니다.
```sollang
import std.sequence
makeValues values: Range -> Stream {
values -> defer
}
main {
1..3 -> makeValues => values
values -> each value {
"$value" -> println
}
}
```
## Stream은 컨테이너가 아니다
`Stream`를 배열 같은 컨테이너로 만들지는 않았습니다. 여전히 지연 실행 계획입니다.
로컬 파이프라인은 원본 loop 안으로 완전히 fusion됩니다. 중간 배열도 없고, iterator object도 없고, 단계마다 callback 객체를 만들지도 않습니다.
함수나 라이브러리 경계를 넘어야 할 때만 다음 세 값으로 구성된 producer ABI를 사용합니다.
- producer context
- `next(context, output)`
- `drop(context)`
즉, 라이브러리화를 하더라도 전체 데이터를 메모리에 복사하지 않습니다. 값을 하나씩 당겨 소비합니다.
그리고 stream은 affine value입니다. 한 번 terminal `each`로 소비한 stream을 다시 사용하면 컴파일 오류가 납니다. 성능을 위해 수명을 숨기지 않고, 소유권 규칙으로 드러냈습니다.
## EventStream도 같은 철학으로
마우스 이동이나 클릭 같은 이벤트는 일반 stream보다 조금 더 까다롭습니다. 생산자가 외부에 있고, 소비자가 느릴 수 있으며, 종료할 때 background worker와 터미널 상태까지 정리해야 합니다.
그래서 `EventStream`에는 다음 규칙을 넣었습니다.
- 생성 후 커지지 않는 fixed-capacity ring buffer
- `DropNewest`, `DropOldest`, `CoalesceMotion` overflow 정책
- 취소 요청과 blocked I/O 깨우기
- worker join
- 콘솔과 터미널 모드 복원
Windows에서는 `ReadConsoleInputW`의 실제 `MOUSE_EVENT_RECORD`를 읽습니다. Linux에서는 SGR 1003/1006 마우스 프로토콜을 처리합니다.
마우스 이동은 매우 자주 발생하기 때문에 무제한 queue는 선택하지 않았습니다. 특히 `CoalesceMotion`은 오래된 이동 좌표를 모두 쌓는 대신 최신 위치 중심으로 처리할 수 있게 합니다.
## 브라우저에서는 왜 바로 지원하지 않았나
브라우저 Pointer Event는 host event loop가 callback으로 전달합니다.
그런데 현재의 synchronous pull stream이 같은 main thread에서 이벤트를 기다리면, 정작 이벤트 callback이 실행될 수 없습니다. 겉으로만 지원하는 척 polling을 넣거나 unresolved import를 남기는 대신, 현재는 명확한 capability diagnostic을 출력하도록 했습니다.
브라우저용 EventStream은 이후 host-driven callback lowering으로 연결하는 것이 맞다고 판단했습니다.
## 조용히 무시되던 println2도 수정
플레이그라운드에서 다음 코드를 실행하면 기존에는 잘못된 함수 호출이 무시됐습니다.
```sollang
"값이 왼쪽에서 오른쪽으로 흐릅니다." -> println2
```
이제는 정상적으로 다음 오류가 표시됩니다.
```text
알 수 없는 함수 호출 'println2'
```
Reference compiler, self-host compiler, 브라우저 Stage2와 실제 공개 플레이그라운드 UI까지 같은 동작으로 맞췄습니다.
## 검증 결과
- Windows 전체 회귀 785/785
- Linux 전체 회귀 785/785
- Windows/Linux Stage2 검증 통과
- Windows/Linux Stage3 fixed point 일치
- 브라우저 Stream 프로그램 5종과 오류 진단 통과
- 전역 Sollang 0.2.260725 설치 및 실행 확인
- 공개 플레이그라운드 TLS와 실제 UI 실행 확인
Stage2 전체 분석은 기존 101.8초 기준에서 약 60초 수준으로 줄었습니다. 기능 표면이 더 커졌는데도 이전보다 빨라졌습니다.
“메모리를 전혀 사용하지 않는다”는 표현은 정확하지 않습니다. 로컬 fusion은 중간 할당이 없고, 라이브러리 경계에서는 작은 producer context 하나, EventStream은 사용자가 정한 고정 크기 ring buffer를 사용합니다.
중요한 것은 메모리 사용량이 입력 데이터 크기에 따라 몰래 증가하지 않는다는 점입니다.
이번 구현으로 Sollang의 stream은 예쁜 예제 문법을 넘어, 변수와 함수, 라이브러리 경계를 실제로 통과할 수 있는 언어 기능이 되었습니다.
---
# SLang이라는 작은 언어를 만들기 시작했습니다
- Public log: https://slogs.dev/@dimohy/slang-small-language-start
- Markdown version: https://slogs.dev/@dimohy/slang-small-language-start.md
- Slogger home: @dimohy
- Published: 2026-07-07
- Updated: 2026-07-08
- Reading span: 15 minutes
- Tags: #slang, #llvm, #dotnet, #compiler, #language
- Log series: SmallLang 개발기
- Representative image: https://slogs.dev/uploads/20260708112406570-smalllang-cover-69f7e5f0a0f74f73aa0914fbd4da14db.png
## Summary
작은 언어 SLang의 현재 문법, value-flow 호출, source-generated lexer/parser, LLVM 기반 네이티브 실행 파일 생성 흐름을 정리한 개발기입니다.
## Knowledge-Log Body
안녕하세요. 이번에는 `SmallLang`이라는 작은 언어를 사부작 만들고 있습니다.
아직은 정말 작습니다. 언어라고 부르기엔 조금 민망할 정도로요… ^^;
그래도 이제 첫 문법이 조금 더 SmallLang 다워졌습니다.
```slang
getName: -> Text {
"dimohy"
}
square: Int -> Int {
it * it
}
main {
getName -> name
7 -> square -> num
"Hello, {name}. square = {num}" -> print
}
```
출력은 이렇습니다.
```text
Hello, dimohy. square = 49
```
그리고 이 코드는 LLVM IR로 내려간 뒤 Windows x64 네이티브 실행 파일로 링크됩니다. 현재 생성된 exe 크기는:
```text
1,088 bytes
```
헐… 아직 기능이 작긴 하지만, 실제 실행 파일까지 만들어지는 걸 보면 재미있습니다.
## 문법은 어디로 가고 있나?
처음부터 정하고 싶었던 것은 `let`이나 `var` 없이도 자연스럽게 읽히는 바인딩이었습니다.
```slang
name = "dimohy"
```
여기에 최근에는 값의 흐름을 더 잘 보이게 하는 `->` 문법을 넣었습니다.
```slang
getName -> name
7 -> square -> num
"Hello, {name}. square = {num}" -> print
```
`getName -> name`은 `getName` 함수를 호출해서 그 결과를 `name`에 바인딩합니다.
`7 -> square -> num`은 7이라는 값이 `square` 함수로 흘러가고, 그 결과가 `num`에 바인딩됩니다.
괄호로 쓰면 `num = square(7)` 같은 형태도 가능하지만, SmallLang에서는 일단 "값이 어디로 흘러가는지"가 눈에 보이는 쪽을 선호해보려고 합니다.
함수 타입도 같은 방향성을 갖습니다.
```slang
square: Int -> Int {
it * it
}
```
지금은 입력이 하나인 함수에서 그 입력을 암묵적으로 `it`으로 받습니다. 그래서 `it * it`이 됩니다. 조금 과감한 선택이긴 한데, 작은 함수에서는 꽤 단순하게 읽히네요.
## 문자열과 숫자
문자열 보간은 가장 작은 형태로 시작했습니다.
```slang
"Hello, {name}. square = {num}"
```
아직은 `{name}`처럼 바인딩 이름을 넣는 정도입니다. 복잡한 표현식을 문자열 안에 바로 넣는 건 조금 더 생각해보려고 합니다. 너무 빨리 다 넣으면 언어가 금방 무거워지더군요.
숫자는 현재 64-bit 정수 리터럴과 `+`, `*`를 지원합니다. `*`가 `+`보다 먼저 묶이고, 둘 다 왼쪽 결합입니다.
## 내부는 어떻게 되어 있나?
컴파일러는 최신 .NET과 C# Preview 기준으로 만들고 있습니다.
처음에는 빠르게 만들다 보니 `Program.cs`에 Lexer까지 들어갔는데… 아아… 이건 바로 정리했습니다. 지금은 역할별로 나누어 두었습니다.
- `Cli`
- `Lexing`
- `Parsing`
- `Syntax`
- `Semantics`
- `CodeGen`
- `Tooling`
Lexer와 Parser도 손으로 직접 박아두지 않고, 작은 규칙 파일에서 소스 생성기로 만들어지게 했습니다.
Lexer 규칙은 이런 식입니다.
```text
token Identifier = identifier
token String = quoted_string
token Number = number
token Plus = "+"
token Star = "*"
token Arrow = "->"
token Colon = ":"
token Equal = "="
```
Parser 규칙도 별도 파일에 둡니다.
```text
rule FunctionDeclaration = Identifier Colon FunctionSignature LeftBrace NewLine* Expression NewLine* RightBrace
rule FunctionSignature = Arrow TypeName | TypeName Arrow TypeName
rule FlowExpression = AdditiveExpression (Arrow Path)*
rule AdditiveExpression = MultiplicativeExpression (Plus MultiplicativeExpression)*
rule MultiplicativeExpression = PrimaryExpression (Star PrimaryExpression)*
```
Roslyn incremental source generator가 `syntax/smalllang.lexer`, `syntax/smalllang.grammar`를 읽고 `Lexer`, `TokenKind`, `Parser`를 생성합니다.
문법을 표현하는 곳과 C# 구현 코드를 분리하고 싶었습니다. 언어를 만드는 중인데, 언어 문법이 C# 코드 안에 너무 묻혀 있으면 조금 아쉽더군요.
## 실제로는 어떻게 실행되나?
현재 파이프라인은 이렇습니다.
```text
SmallLangsource
-> generated lexer
-> generated parser
-> AST
-> semantic analysis
-> LLVM IR
-> clang object
-> lld-link exe
```
LLVM은 저장소에 넣지 않습니다. 빌드 스크립트가 없으면 `.tools` 아래로 내려받고, 도구와 산출물은 Git에 들어가지 않게 했습니다.
이번 샘플은 컴파일 시점에 전체 문자열 하나로 접어버릴 수도 있습니다. 하지만 일부러 런타임 함수 호출이 보이도록 했습니다.
생성된 LLVM IR에는 이런 형태가 들어갑니다.
```llvm
define internal i64 @smalllang_fn_square(i64 %it) #0 {
entry:
%mul0 = mul nsw i64 %it, %it
ret i64 %mul0
}
```
그리고 `main` 쪽에서는 실제로 이렇게 호출합니다.
```llvm
%call4 = call i64 @slang_fn_square(i64 7)
```
출력은 아직 `print` 하나입니다. 표면에서는:
```slang
"Hello, {name}. square = {num}" -> print
```
이지만 내부적으로는 문자열 조각을 UTF-8 정적 데이터로 두고, 정수는 런타임에서 십진수로 변환해 `WriteFile`로 바로 씁니다. CRT는 붙이지 않았습니다.
## 아직 남은 것들
아직 정해야 할 게 많습니다.
타입 시스템, 모듈 시스템, 메모리 모델, 크로스 플랫폼 출력, 오류 처리, 문자열 escape, `println` 여부…
후덜덜하네요 ^^;
그래도 첫 느낌은 괜찮습니다. 아주 작은 문법에서 시작해서, 직접 토큰화하고, 파싱하고, LLVM으로 내려가고, 실제 실행 파일이 만들어지는 흐름까지는 연결됐습니다.
다음은 문법을 조금씩 키워보면서도 "단순함"을 잃지 않는 쪽으로 가보려고 합니다.
가장 작은 언어가 어디까지 아름다워질 수 있을까요?
불타보아요… ^^
---
# .NET System.Net.Quic으로 방화벽 뒤 P2P(홀펀칭) 뚫어보기
- Public log: https://slogs.dev/@dimohy/system-net-quic-holepunching-p2p
- Markdown version: https://slogs.dev/@dimohy/system-net-quic-holepunching-p2p.md
- Slogger home: @dimohy
- Published: 2026-07-03
- Updated: 2026-07-06
- Reading span: 14 minutes
- Tags: #quic, #p2p, #dotnet, #홀펀칭, #nat
- Representative image: https://slogs.dev/uploads/20260702235856249-system-net-quic-holepunching-p2p-cover-8bbc0dfa48e546719710ee686cfb99cf.png
## Summary
.NET에 들어온 QUIC로 방화벽/NAT 뒤에서 P2P가 될까? MsQuic의 소켓 주입 불가라는 함정을 close & rebind로 우회하고, presence 서버 + 자체 STUN + 자동 재연결까지 만들어본 연구 기록입니다.
## Knowledge-Log Body
안녕하세요. 이번에는 요즘 사부작사부작 파보던 주제 하나를 공유해봅니다. 바로 **.NET의 `System.Net.Quic`으로 방화벽 뒤에서 P2P 연결이 될까?** 하는 이야기입니다 ^^
시작은 단순한 궁금증이었어요. 최근 .NET에 들어온 QUIC… TCP도 아니고 UDP 기반이라던데, 이거라면 그 어렵다는 NAT/방화벽 뚫기(홀펀칭)를 해볼 수 있지 않을까? 하는 생각이었습니다.
## QUIC이 왜 P2P에 어울릴까요
QUIC은 UDP 위에서 도는 전송 프로토콜입니다. .NET 7부터 `System.Net.Quic`으로 정식 노출되었고, 내부적으로는 MsQuic을 씁니다. TLS 1.3이 기본이라 암호화는 공짜고, 연결 마이그레이션 같은 재미난 기능도 있죠.
무엇보다 **UDP 기반**이라는 점이 중요합니다. TCP로는 거의 불가능한 UDP 홀펀칭을 쓸 수 있거든요. P2P NAT 통과의 핵심이 바로 이 홀펀칭입니다.
## 그런데… `System.Net.Quic`엔 함정이 하나 있습니다
먼저 검증된 사례들을 찾아봤는데요, go-libp2p나 quic-go(Go) 같은 곳은 이미 프로덕션에서 QUIC 홀펀칭을 잘 하고 있었습니다. 그 비결은 **"하나의 UDP 소켓을 STUN·펀칭·QUIC가 전부 공유"** 하는 것이었어요.
문제는 여기서 생깁니다. `System.Net.Quic`은 내부의 MsQuic이 **자기 소켓을 직접 열어버려서, 내가 만든 소켓을 주입할 방법이 없습니다.** 아… 여기서 좀 막혔죠 ^^;
그래서 생각해낸 우회가 **"close & rebind"** 입니다. 이름 그대로예요.
1. 펀칭용 `UdpClient`를 로컬 포트 `P`에 열고, 상대에게 패킷을 쏴서 NAT에 구멍을 뚫고…
2. 그 소켓을 **닫은 뒤**,
3. QUIC를 **같은 포트 `P`** 로 다시 바인딩합니다. (`LocalEndPoint` / `ListenEndPoint` 지정)
말로만 하면 좀 헷갈리니, 그림 하나 그려봤습니다.
```text
[로컬 포트 P]
│
├─ ① UdpClient로 상대에게 펀칭 패킷 발사 ──► NAT에 구멍이 뚫림!
│
├─ ② 펀칭 소켓 close (포트 P 반납)
│
└─ ③ QUIC를 같은 포트 P로 rebind ─────────► 뚫린 그 구멍으로 QUIC 핸드셰이크
(LocalEndPoint = P)
```
대부분의 cone NAT은 매핑을 내부 `(IP, 포트)` 기준으로 잡기 때문에, 같은 포트로 다시 올리면 뚫어둔 구멍이 그대로 유지되더라고요. 이게 될까 싶었는데… 되네요!
```csharp
// 펀칭용 소켓으로 구멍을 뚫고 닫은 뒤,
// 같은 로컬 포트로 QUIC를 다시 올립니다.
var options = new QuicClientConnectionOptions
{
LocalEndPoint = new IPEndPoint(IPAddress.Any, localPort), // ★ 핵심
RemoteEndPoint = peerEndpoint,
// ... TLS, KeepAlive 등
};
var connection = await QuicConnection.ConnectAsync(options);
```
> **핵심 한 줄:** 소켓을 공유하진 못해도, *같은 포트로 다시 바인딩* 하면 뚫어둔 NAT 구멍을 QUIC가 그대로 물려받습니다.
## 실제로 만들어봤습니다
말로만 하면 재미없으니 작은 PoC를 만들어봤어요. 전체 흐름은 이렇습니다.
```mermaid
sequenceDiagram
autonumber
participant A as 피어A
participant S as 내 서버 (presence + STUN)
participant B as 피어B
A->>S: 상시 접속(SSE)
B->>S: 상시 접속(SSE)
Note over A,B: 둘 다 online 확인
S-->>A: 상대 주소 + 펀치 시각
S-->>B: 상대 주소 + 펀치 시각
par 동시에 펀칭
A->>B: 펀칭 패킷
B->>A: 펀칭 패킷
end
Note over A,B: close → 같은 포트로 QUIC rebind
A->>B: 직접 QUIC P2P 연결
Note over A,B: 서버 경유 X
```
- **presence 서버**: 각 피어가 상시 접속(SSE)해서 "누가 온라인인지" 서버가 압니다. 둘 다 온라인이면 서로의 공인 주소와 동기화된 펀치 시각을 내려줍니다.
- **자체 STUN 리플렉터**: 구글 STUN에 기대지 않고, 내 서버가 UDP로 공인 주소를 되돌려주게 했습니다. 자급자족이죠 ^^
- **자동 재연결**: QUIC 연결이 죽으면(NAT 매핑이 만료되거나 상대가 끊기면) 감지해서 **새 포트로 다시 펀칭**하고 재연결합니다.
마지막 자동 재연결은 Syncthing 사용자분이 "QUIC 홀펀칭이 한 36시간쯤 잘 되다가 죽으면 영영 재연결이 안 된다"고 남긴 글을 보고 꼭 넣고 싶었던 부분이었습니다. 실제로 상대 피어를 강제로 죽여봤더니, 이쪽이 알아서 포트를 바꿔 다시 붙더라고요. 뿌듯 ^^
## 한계는 분명합니다
너무 장밋빛으로만 적으면 안 되겠죠. 솔직하게 남겨둡니다.
- **Symmetric NAT**에서는 이 방식이 깨집니다. 목적지마다 외부 포트가 바뀌거든요. 이건 QUIC의 한계가 아니라 NAT의 한계라, 결국 **TURN 릴레이 폴백**이 필요합니다.
- 아직 **루프백/로컬 검증까지만** 했습니다. 진짜 서로 다른 두 네트워크에서의 NAT 통과는 다음 숙제로 남겨뒀어요. 이 부분은 공인 서버에 올려서 꼭 실측해볼 생각입니다.
- MsQuic이 소켓을 직접 여는 구조라, close→rebind 사이의 아주 짧은 순간은 여전히 경합 구간입니다. (클라이언트가 몇 번 재시도하도록 해뒀습니다.)
## 마무리
정리하면, **"System.Net.Quic으로 홀펀칭이 되냐"는 질문의 답은 '조건부로 됩니다'** 정도가 될 것 같네요. 소켓을 공유하지 못하는 제약을 close & rebind로 메우면, cone NAT 환경에선 직접 QUIC P2P가 성립합니다. 다만 symmetric NAT과 실제 인터넷 검증이라는 숙제가 남아있습니다.
.NET 진영에는 아직 이걸 정면으로 다룬 공개 레퍼런스가 잘 안 보이더라고요. 그래서 살짝 개척자(?)가 된 기분으로 즐겁게 파봤습니다 ^^ 혹시 비슷한 걸 고민하시는 분이 계시면 반갑게 이야기 나눠요.
그럼 다음엔 실제 NAT 통과 성공기로 돌아오겠습니다… 되기를 바라며 ^^;
---
# Slogs Obsidian Drive 사용 가이드
- Public log: https://slogs.dev/@dimohy/slogs-obsidian-drive-guide-20260629
- Markdown version: https://slogs.dev/@dimohy/slogs-obsidian-drive-guide-20260629.md
- Slogger home: @dimohy
- Published: 2026-06-29
- Updated: 2026-06-29
- Reading span: 31 minutes
- Tags: #slogs, #obsidian, #drive, #winfsp, #동기화
- Log series: slogs 사용 가이드
- Representative image: https://slogs.dev/uploads/20260629083755923-slogs-obsidian-drive-architectur-cfe7aebdcc7646e892f35ea95d606598.webp
## Summary
Windows에서 GitHub Release 기반 winget manifest로 Slogs Obsidian Drive를 설치하고, NativeAOT 실행 파일로 slogs 원격 Obsidian vault를 로컬 드라이브처럼 여는 방법을 정리한 사용 가이드입니다.
## Knowledge-Log Body
Slogs Obsidian Drive는 slogs 원격 Obsidian vault를 Windows 로컬 드라이브처럼 마운트하는 도구입니다. Obsidian 플러그인을 설치하지 않아도, 마운트된 드라이브나 폴더를 Obsidian vault로 열어 Markdown 파일을 읽고 쓸 수 있습니다.
핵심 구조는 단순합니다. Drive 프로그램이 `obsidian.sync` 토큰으로 slogs API에 접속하고, WinFsp가 Windows 파일시스템 인터페이스를 제공합니다. 사용자는 `S:` 같은 드라이브를 열어 평소처럼 파일을 만들고 수정합니다.
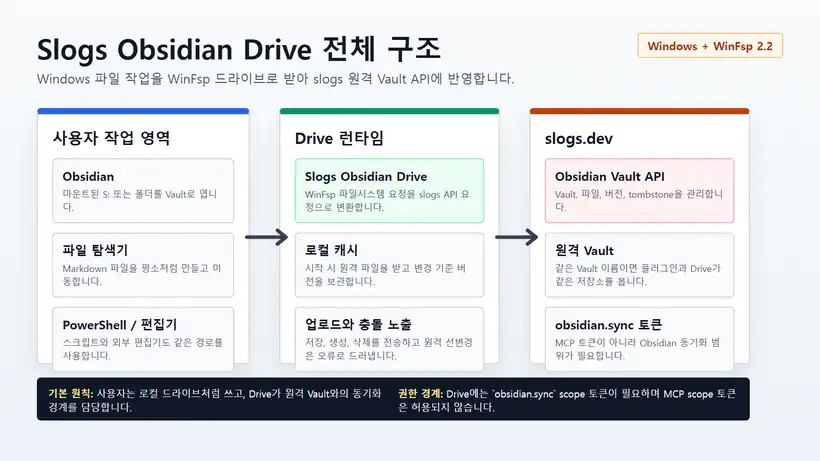
> 2026년 6월 29일 기준 Drive는 Windows 전용입니다. 배포 파일은 GitHub Release의 NativeAOT `win-x64` 실행 파일이며, 현재 즉시 설치는 GitHub Release를 가리키는 winget manifest로 진행합니다. WinFsp가 없으면 Drive 설치기가 공식 WinFsp GitHub Release의 `winfsp-2.2.26112.msi`를 내려받아 설치합니다.
## 언제 Drive를 쓰나
Drive는 다음 상황에 적합합니다.
- Obsidian 플러그인 설치 없이 원격 vault를 로컬 폴더처럼 열고 싶을 때
- Obsidian 외부 편집기, PowerShell, 파일 탐색기에서 같은 원격 vault를 다루고 싶을 때
- Windows에서 `S:` 같은 드라이브 문자로 Slogs vault를 연결하고 싶을 때
- 기본 Markdown 동기화에 집중하고, 첨부 파일과 `.obsidian` 설정은 명시적으로 켜고 싶을 때
Obsidian 플러그인과 Drive는 같은 slogs Obsidian API와 같은 `obsidian.sync` 토큰 범위를 사용합니다. 같은 원격 vault 이름을 쓰면 두 방식이 같은 원격 저장소를 바라봅니다.
## 준비물
- Windows
- `winget`
- slogs 계정
- slogs에서 생성한 `obsidian.sync` scope Bearer 토큰
소스 저장소의 `src/Slogs.Obsidian.Drive` 프로젝트를 직접 실행할 필요가 없습니다. 일반 사용자는 winget manifest 또는 GitHub Release에 올라간 Drive 설치기를 사용합니다.
토큰은 slogs의 우측 상단 계정 메뉴에서 `설정`으로 들어간 뒤, Obsidian 동기화 용도로 새로 만듭니다. MCP용 `mcp` scope 토큰은 Drive에 사용할 수 없습니다.
## 설치하기
PowerShell에서 다음 명령을 실행합니다.
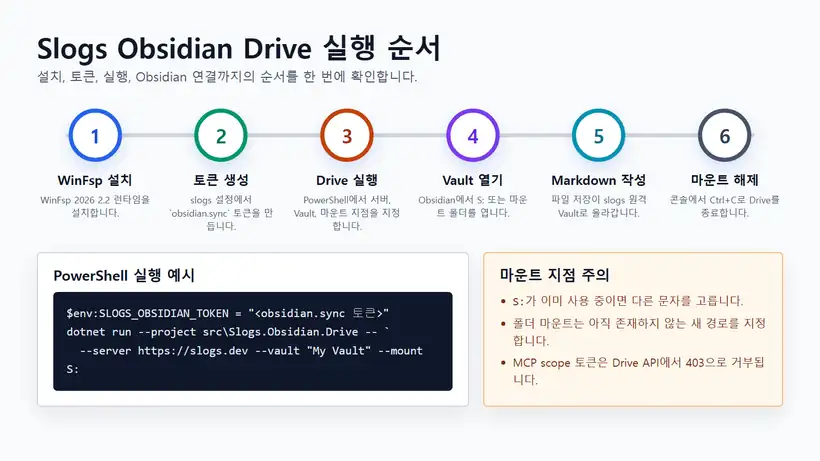
현재 `Dimohy.SlogsObsidianDrive`는 winget-pkgs PR이 병합되어 공식 소스에 반영되기 전입니다. 그래서 지금 바로 설치하려면 저장소의 winget manifest를 임시 폴더에 내려받고, 그 manifest로 GitHub Release 설치기를 실행합니다.
```powershell
$manifest = Join-Path $env:TEMP "SlogsObsidianDrive-winget"
Remove-Item $manifest -Recurse -Force -ErrorAction SilentlyContinue
New-Item -ItemType Directory -Force -Path $manifest | Out-Null
$base = "https://raw.githubusercontent.com/dimohy/slogs/main/packaging/winget/manifests/d/Dimohy/SlogsObsidianDrive/0.1.0"
@("Dimohy.SlogsObsidianDrive.yaml","Dimohy.SlogsObsidianDrive.locale.en-US.yaml","Dimohy.SlogsObsidianDrive.installer.yaml") | ForEach-Object {
Invoke-WebRequest "$base/$_" -OutFile (Join-Path $manifest $_)
}
winget install --manifest $manifest --accept-package-agreements --accept-source-agreements
```
winget-pkgs PR이 병합되고 사용자의 winget source index가 갱신된 뒤에는 다음 짧은 명령만으로 설치할 수 있습니다.
```powershell
winget install --id Dimohy.SlogsObsidianDrive --exact
```
GitHub Release 설치 EXE를 직접 받은 경우에도 같은 설치 모드로 실행할 수 있습니다.
```powershell
.\SlogsObsidianDrive-0.1.0-win-x64.exe --install
```
릴리스 위치는 다음과 같습니다.
- https://github.com/dimohy/slogs/releases/tag/slogs-obsidian-drive-v0.1.0
설치기는 사용자 프로그램 폴더에 `SlogsObsidianDrive.exe`를 설치하고 사용자 `PATH`에 등록합니다. 새 터미널을 열면 `SlogsObsidianDrive` 명령을 바로 사용할 수 있습니다.
WinFsp가 설치되어 있지 않으면 설치기가 공식 WinFsp GitHub Release에서 다음 MSI를 내려받아 설치합니다.
```text
https://github.com/winfsp/winfsp/releases/download/v2.2B1/winfsp-2.2.26112.msi
```
WinFsp 설치는 Windows 드라이버 설치이므로 UAC 권한 상승 창이 나타날 수 있습니다.
## 실행하기
PowerShell에서 토큰을 환경 변수로 넣고 Drive를 실행합니다.
```powershell
$env:SLOGS_OBSIDIAN_TOKEN = ""
SlogsObsidianDrive --server https://slogs.dev --vault "My Vault" --mount S:
```
`--vault`는 slogs 원격 vault 이름입니다. 같은 이름을 다른 기기에서도 사용하면 같은 원격 vault에 연결됩니다.
`--mount`는 Windows 드라이브 문자나 NTFS 디렉터리 마운트 지점입니다.
```powershell
--mount S:
```
또는 아직 존재하지 않는 NTFS 디렉터리 경로를 마운트 지점으로 사용할 수 있습니다. 이미 만들어 둔 빈 폴더를 지정하면 WinFsp preflight가 `0xc0000035`로 실패할 수 있으니, Drive가 만들 수 있는 새 경로를 지정하세요.
```powershell
--mount C:\Mounts\SlogsVault
```
이 경우 `C:\Mounts` 상위 폴더는 준비되어 있어야 하지만, `SlogsVault` 폴더는 미리 만들지 않는 쪽이 안전합니다.
실행이 성공하면 Drive는 원격 파일을 로컬 캐시에 먼저 동기화한 뒤 마운트를 시작합니다. 콘솔에 “Open this drive or mount directory in Obsidian. Press Ctrl+C to unmount.” 메시지가 나오면 Obsidian에서 해당 드라이브나 폴더를 vault로 열면 됩니다.
종료할 때는 실행 중인 콘솔에서 `Ctrl+C`를 누릅니다. Drive가 마운트를 해제하고 종료합니다.
## 주요 옵션
| 옵션 | 설명 |
| --- | --- |
| `--server https://slogs.dev` | 접속할 slogs 서버입니다. 기본값은 `https://slogs.dev`입니다. |
| `--vault "My Vault"` | 원격 Obsidian vault 이름입니다. 필수입니다. |
| `--mount S:` | 드라이브 문자 또는 NTFS 디렉터리 마운트 지점입니다. 필수입니다. |
| `--token ` | `obsidian.sync` 토큰입니다. 환경 변수 대신 명령줄로 줄 수 있습니다. |
| `--cache ` | 로컬 작업 캐시 위치입니다. 기본값은 `%LOCALAPPDATA%\Slogs\ObsidianDrive\`입니다. |
| `--poll-seconds 30` | 원격 변경 확인 주기입니다. `0`이면 polling을 끕니다. |
| `--sync-attachments true` | Markdown이 아닌 파일도 동기화합니다. 기본값은 `false`입니다. |
| `--sync-settings true` | `.obsidian` 설정 파일도 동기화합니다. 기본값은 `false`입니다. |
토큰은 `--token` 또는 `SLOGS_OBSIDIAN_TOKEN`에서 읽습니다. 토큰 값은 로그나 상태 파일에 기록하지 않습니다.
## 드라이브 용량 표시
Windows 파일 탐색기와 드라이브 속성에는 실제 PC 디스크 용량이 아니라 slogs Obsidian 저장소 한도가 표시됩니다.
- 전체 용량: 계정당 Obsidian 저장소 한도입니다. 기본값은 `1GB`입니다.
- 사용 중인 공간: 현재 연결된 원격 vault의 활성 파일 크기 합계입니다.
- 여유 공간: `계정 한도 - 현재 vault 사용량`입니다.
이 값은 로컬 캐시가 들어 있는 물리 디스크의 남은 공간이 아닙니다. 예를 들어 PC 디스크가 수백 GB 남아 있어도, Drive 속성에는 slogs 계정 한도 기준인 최대 `1GB`가 보입니다.
## 동기화 범위
기본값은 Markdown 중심입니다.
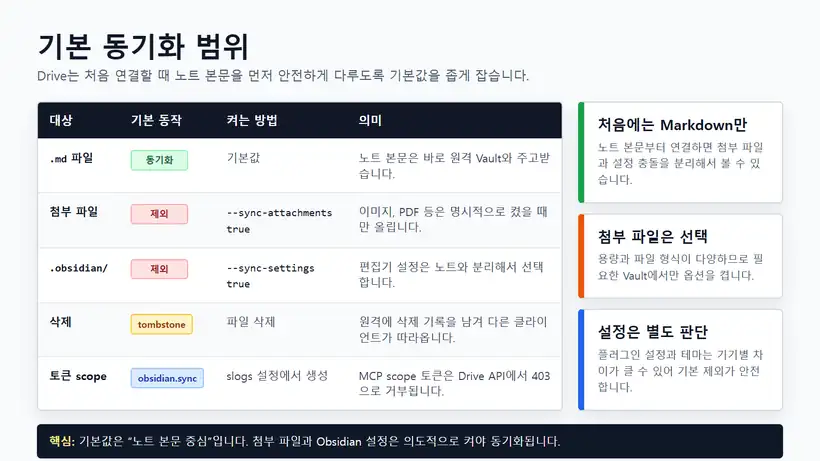
- `.md` 파일은 기본으로 동기화합니다.
- `.obsidian/` 아래 설정 파일은 기본으로 제외합니다.
- 이미지, PDF, 기타 첨부 파일은 기본으로 제외합니다.
- 첨부 파일은 `--sync-attachments true`를 켰을 때만 동기화합니다.
- `.obsidian` 설정은 `--sync-settings true`를 켰을 때만 동기화합니다.
이 기본값은 의도적입니다. 노트 본문, 첨부 파일, 편집기 설정은 성격이 다르기 때문에 처음 연결할 때 모두 한꺼번에 섞지 않습니다.
## 내부 동작 방식
Drive는 로컬 캐시와 slogs 원격 vault 사이를 중재합니다.
- 시작 시 원격 변경을 받아 로컬 캐시를 준비합니다.
- 마운트된 드라이브에서 파일을 만들거나 수정하면 해당 변경을 slogs API로 올립니다.
- 파일 삭제는 원격에서 tombstone으로 기록됩니다.
- 각 파일은 `path`, `contentHash`, `version` 기준으로 충돌을 판단합니다.
- 원격 파일이 기준 버전 이후 이미 바뀐 상태라면 Drive는 조용히 덮어쓰지 않고 파일시스템 오류로 충돌을 드러냅니다.
로컬 캐시의 상태 파일은 마운트된 vault 안이 아니라 캐시 디렉터리의 `state.json`에 저장됩니다. 사용자가 Obsidian에서 보는 vault 루트에는 Drive 내부 상태 파일을 섞지 않습니다.
## Obsidian에서 열기
1. Drive를 실행해 `S:` 같은 마운트 지점을 만듭니다.
2. Obsidian에서 `Open folder as vault`를 선택합니다.
3. `S:` 또는 지정한 마운트 폴더를 선택합니다.
4. Markdown 파일을 만들고 수정합니다.
5. Drive 콘솔을 계속 켜 둡니다.
Drive가 실행 중인 동안에는 Obsidian, 파일 탐색기, 다른 편집기에서 같은 마운트 경로를 사용할 수 있습니다.
## 문제 해결
| 증상 | 확인할 것 |
| --- | --- |
| `winget`에서 패키지를 찾지 못함 | 아직 winget-pkgs PR merge와 source index 반영 전입니다. 위의 `winget install --manifest` 명령을 사용하거나 GitHub Release EXE를 받아 `--install`로 설치합니다. |
| WinFsp 설치 중 UAC 창이 뜸 | WinFsp는 파일시스템 드라이버이므로 관리자 권한 설치가 필요합니다. |
| `--token or SLOGS_OBSIDIAN_TOKEN is required.` | `obsidian.sync` 토큰을 환경 변수나 `--token`으로 전달합니다. |
| 401 Unauthorized | 토큰 누락, 오타, 앞뒤 공백을 확인합니다. |
| 403 Forbidden | MCP용 `mcp` 토큰을 넣은 경우입니다. Obsidian 동기화 용도 토큰을 새로 만듭니다. |
| 드라이브 문자 마운트 실패 | `S:`가 이미 사용 중인지 확인하거나 다른 드라이브 문자를 사용합니다. |
| 폴더 마운트 preflight 실패 `0xc0000035` | 이미 존재하는 폴더를 지정한 경우일 수 있습니다. 상위 폴더만 준비하고, 아직 존재하지 않는 새 마운트 경로를 지정합니다. |
| 파일 저장 중 오류 | 원격 파일이 먼저 바뀐 충돌일 수 있습니다. 원격/로컬 내용을 확인한 뒤 다시 저장합니다. |
| 드라이브 속성에 PC 디스크 용량이 보임 | 오래된 Drive 실행 파일일 수 있습니다. 위의 설치 명령으로 최신 GitHub Release 설치기를 다시 설치한 뒤 새 터미널에서 실행합니다. |
## 플러그인과 Drive 중 무엇을 선택할까
둘 중 하나만 써도 됩니다.
- Obsidian 안에서 버튼과 명령 팔레트 중심으로 쓰려면 플러그인이 편합니다.
- Windows 파일시스템처럼 열고 싶으면 Drive가 편합니다.
- 같은 `vault` 이름과 같은 slogs 계정을 쓰면 두 방식은 같은 원격 vault를 공유합니다.
다만 같은 파일을 여러 기기나 여러 클라이언트에서 동시에 수정하면 충돌이 날 수 있습니다. 한쪽에서 작업을 끝낸 뒤 다른 쪽에서 변경을 받아 쓰는 흐름이 안전합니다.
## 관련 글
- [Slogs Obsidian 동기화 사용 가이드](/@dimohy/slogs-obsidian-sync-guide-20260629)
- [Slogs GitHub Releases](https://github.com/dimohy/slogs/releases)
- [WinFsp 릴리스](https://github.com/winfsp/winfsp/releases/tag/v2.2B1)
- [winfsp.net NuGet 패키지](https://www.nuget.org/packages/winfsp.net)
## 한 줄 요약
Slogs Obsidian Drive는 slogs 원격 Obsidian vault를 Windows 로컬 드라이브처럼 열어 주는 WinFsp 기반 연결 도구입니다. 현재 설치는 GitHub Release를 가리키는 winget manifest로 처리하고, 기본은 Markdown 동기화이며 첨부 파일과 `.obsidian` 설정은 명시적으로 켰을 때만 동기화합니다.
---
# Slogs Obsidian 동기화 사용 가이드
- Public log: https://slogs.dev/@dimohy/slogs-obsidian-sync-guide-20260629
- Markdown version: https://slogs.dev/@dimohy/slogs-obsidian-sync-guide-20260629.md
- Slogger home: @dimohy
- Published: 2026-06-29
- Updated: 2026-06-29
- Reading span: 31 minutes
- Tags: #slogs, #obsidian, #동기화, #drive, #markdown
- Log series: slogs 사용 가이드
- Representative image: https://slogs.dev/uploads/20260629001801797-slogs-obsidian-sync-hero-7df84775f74b4e28bbdba8e69403f810.png
## Summary
Slogs 계정에 연결된 사용자별 원격 Obsidian vault를 공식 커뮤니티 플러그인 Slogs Sync 0.1.2 이상 또는 Windows Drive로 동기화하는 방법과 토큰, 동기화 범위, 충돌 처리, 현재 Drive 설치 기준을 정리한 사용 가이드입니다.
## Knowledge-Log Body
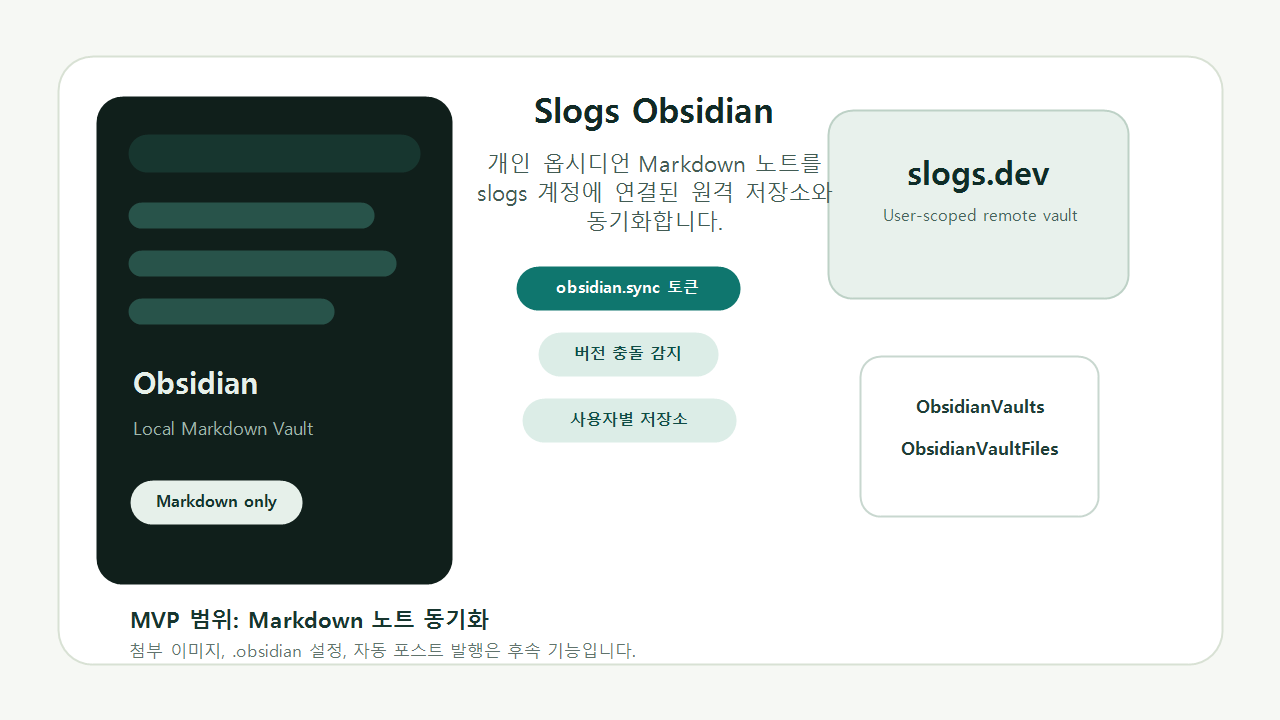
Obsidian은 로컬 Markdown 노트에 강하고, slogs는 계정 기반의 원격 저장소와 공개 글 발행 흐름에 강합니다. **Slogs Obsidian Sync**는 이 둘 사이에 사용자별 원격 vault를 만들고, 여러 클라이언트가 같은 slogs 계정의 vault를 기준으로 노트를 맞출 수 있게 합니다.
현재 연결 방식은 두 가지입니다.
- **Obsidian 플러그인**: Obsidian 안에서 sync 명령, 충돌 모달, post/LLM Wiki 매핑 옵션을 쓰는 방식입니다.
- **Windows WinFsp Drive**: slogs 원격 vault를 `S:` 같은 로컬 드라이브처럼 마운트하는 방식입니다. Drive는 GitHub Release 기반 NativeAOT 설치기와 winget manifest를 기준으로 배포하며, 자세한 내용은 [Slogs Obsidian Drive 사용 가이드](/@dimohy/slogs-obsidian-drive-guide-20260629)를 참고하세요.
두 방식 모두 slogs 서버가 내 컴퓨터에 직접 접근하는 구조가 아닙니다. 플러그인이나 Drive 클라이언트가 `obsidian.sync` 토큰으로 slogs API에 요청을 보내고, slogs는 사용자별 원격 vault를 저장합니다.
## 무엇을 할 수 있나
- 여러 기기에서 같은 slogs 계정의 원격 Obsidian vault를 기준으로 노트를 맞출 수 있습니다.
- Slogs 계정별로 원격 vault가 분리되므로 다른 사용자의 노트와 섞이지 않습니다.
- 파일은 vault-relative path 기준으로 저장됩니다. 예: `daily/2026-06-29.md`
- 원격 변경 이후의 오래된 로컬 변경은 조용히 덮어쓰지 않고 `obsidianConflict` 충돌로 멈춥니다.
- 삭제는 tombstone으로 기록되어 다른 클라이언트가 삭제 사실을 관찰할 수 있습니다.
- 첨부 파일과 `.obsidian` 설정은 기본값이 아니라 명시적 opt-in으로 동기화합니다.
- 선택한 노트는 frontmatter와 설정을 통해 Slogs 공개 글 또는 LLM Wiki 항목으로 연결할 수 있습니다.
## 준비물
- slogs 계정
- Obsidian 1.6.6 이상
- Obsidian 커뮤니티 플러그인 `Slogs Sync` 0.1.2 이상
- slogs에서 생성한 `obsidian.sync` scope Bearer 토큰
중요한 점은 토큰 범위입니다. **Slogs MCP 토큰의 `mcp` scope는 Obsidian 동기화에 사용할 수 없습니다.** Obsidian 플러그인과 Windows Drive에는 반드시 `obsidian.sync` 용도로 만든 토큰을 넣어야 합니다.
Windows Drive를 쓰는 경우에는 Obsidian 플러그인 대신 Drive를 설치합니다. 지금 바로 설치하려면 GitHub Release를 가리키는 winget manifest를 내려받아 `winget install --manifest`로 설치합니다. `winget install --id Dimohy.SlogsObsidianDrive --exact`는 winget-pkgs PR merge와 source index 반영 후 사용할 수 있습니다. Drive 설치기는 GitHub Release의 NativeAOT 실행 파일을 사용하고, WinFsp가 없으면 공식 WinFsp `2.2.26112` MSI를 내려받아 설치합니다.
## 설정 순서
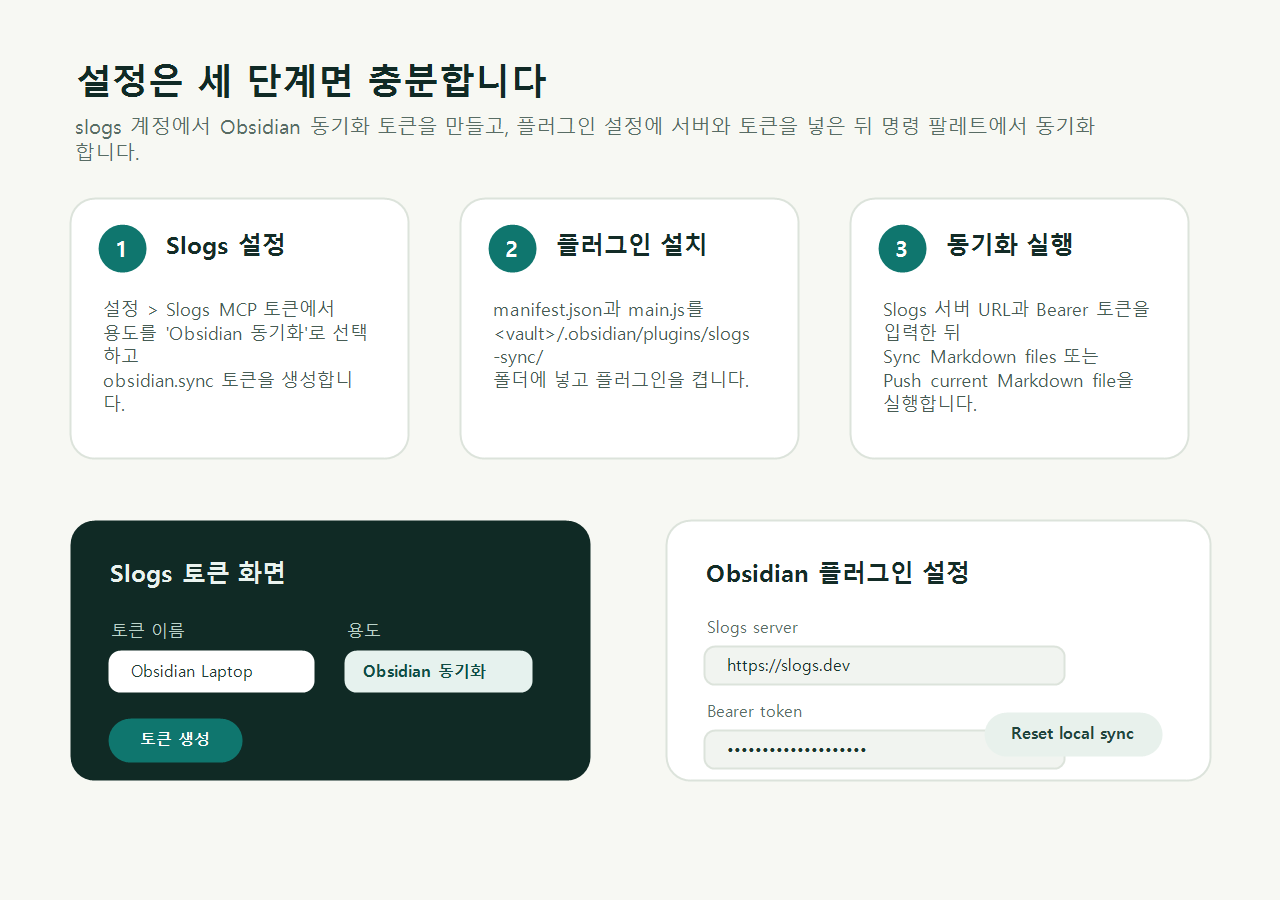
### 1. slogs에서 Obsidian 동기화 토큰 만들기
1. slogs에 로그인합니다.
2. 우측 상단 계정 메뉴에서 `설정`으로 들어갑니다.
3. `Slogs MCP 토큰` 영역에서 용도를 `Obsidian 동기화`로 선택합니다.
4. 토큰 이름을 입력합니다. 예: `Obsidian Laptop`
5. `토큰 생성`을 누르고, 새 토큰을 한 번만 복사합니다.
토큰은 비밀번호처럼 다뤄야 합니다. 문서, 로그, 프롬프트, LLM Wiki, 공개 글에 적지 마세요.
### 2. Obsidian에 플러그인 설치하기
이제 일반 사용자는 Obsidian 안에서 커뮤니티 플러그인으로 바로 설치합니다.
1. Obsidian에서 `Settings > Community plugins`로 이동합니다.
2. 제한 모드를 끄고 `Browse`를 엽니다.
3. `Slogs Sync`를 검색합니다.
4. `Install`을 누른 뒤 `Enable`로 활성화합니다.
5. 설치된 플러그인 버전이 `0.1.2` 이상인지 확인합니다.
테스트 빌드가 필요한 개발/검증 상황에서만 GitHub Release나 BRAT을 사용합니다. 일반 사용자는 vault 내부 폴더를 직접 만들거나 파일을 복사할 필요가 없습니다.
### 3. 플러그인 설정 입력하기
Obsidian의 `Slogs Sync` 설정에서 다음 값을 입력합니다.
```text
Slogs server: https://slogs.dev
Bearer token: slogs에서 만든 obsidian.sync 토큰
Remote vault name: 비워두면 현재 Obsidian vault 이름 사용
```
`Remote vault name`을 바꾸면 플러그인은 새 원격 vault를 찾거나 생성합니다. 같은 slogs 계정 안에서도 여러 vault를 분리해서 운영할 수 있습니다.
## 동기화 명령
명령 팔레트에서 다음 명령을 사용할 수 있습니다.
| 명령 | 용도 |
| --- | --- |
| `Slogs Sync: Sync all Slogs files` | 원격 변경을 받고, 로컬 변경을 올립니다. |
| `Slogs Sync: Push current file to Slogs` | 현재 열려 있는 파일만 원격으로 올립니다. |
| `Slogs Sync: Pull remote changes from Slogs` | 원격 변경만 로컬 vault에 반영합니다. |
| `Slogs Sync: Open mapped Slogs post` | 현재 노트가 Slogs 글로 매핑되어 있으면 해당 글을 엽니다. |
| `Slogs Sync: Open Slogs vault settings` | slogs 설정 화면을 엽니다. |
기본값은 Markdown 파일 동기화입니다. 첨부 파일과 `.obsidian` 설정은 플러그인 설정에서 명시적으로 켠 경우에만 동기화합니다.
## 선택 기능
### 첨부 파일 동기화
`Sync attachments`를 켜면 Markdown이 아닌 파일도 동기화합니다. 이미지, PDF 같은 첨부 파일까지 같은 원격 vault에 넣고 싶을 때만 켜세요.
### `.obsidian` 설정 동기화
`Sync .obsidian settings`를 켜면 `.obsidian` 설정 파일도 동기화합니다. 플러그인 목록, 테마, 워크스페이스 설정은 기기별 차이가 생길 수 있으므로 필요한 경우에만 켜는 것이 좋습니다.
### Slogs 글 매핑
플러그인 설정에서 `Map notes to Slogs posts`를 켠 뒤, 노트 frontmatter에 다음 값을 넣으면 push 후 Slogs 글 매핑 API를 호출합니다.
```yaml
---
slogs.post: true
slogs.slug: my-slogs-post
---
```
### LLM Wiki 매핑
플러그인 설정에서 `Map notes to Slogs LLM Wiki`를 켠 뒤, 노트 frontmatter에 다음 값을 넣으면 push 후 LLM Wiki 매핑 API를 호출합니다.
```yaml
---
slogs.llmWiki: true
slogs.llmWiki.categoryPath: slogs/obsidian-import
---
```
노트 원본 저장소, 공개 글, LLM Wiki 기억은 성격이 다릅니다. 그래서 공개 글과 LLM Wiki 연결은 항상 명시적으로 켠 노트만 대상으로 삼습니다.
## 내부 동작 방식
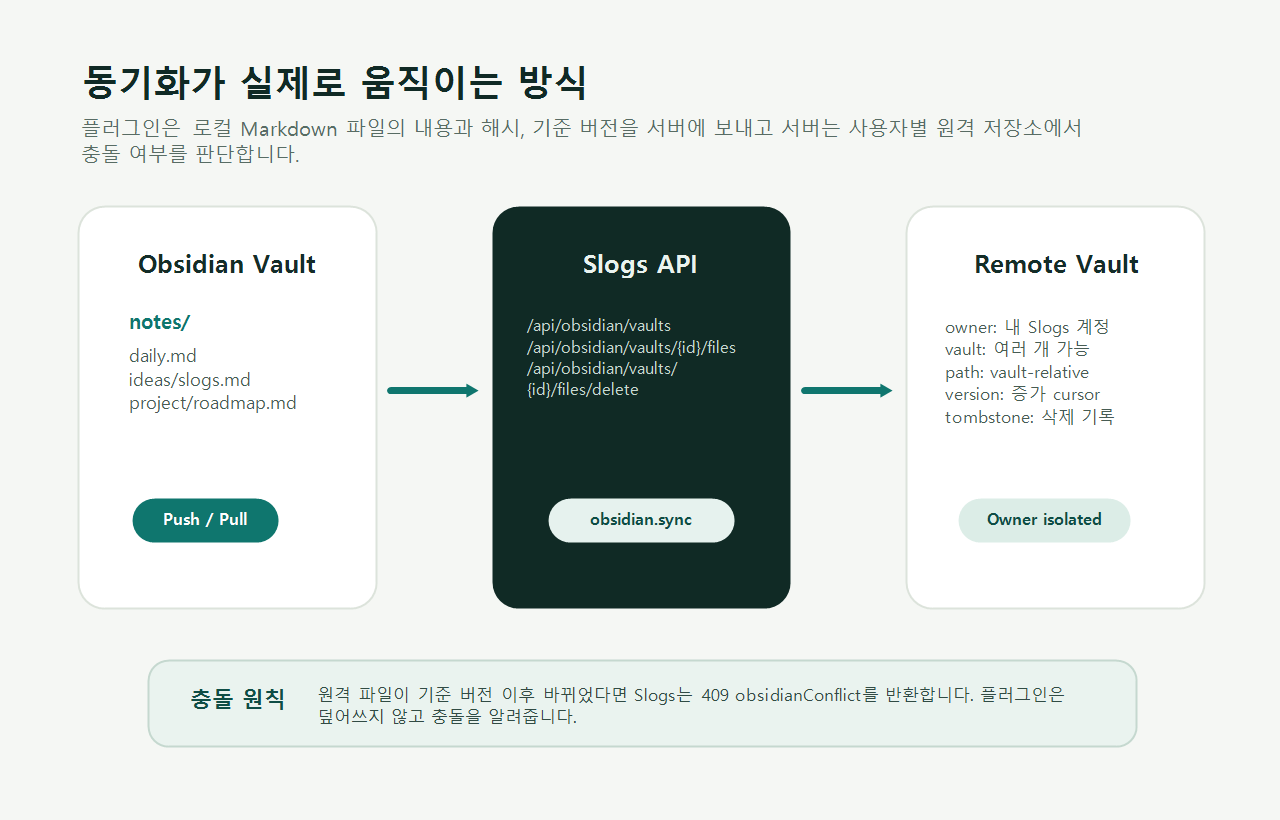
동기화는 세 가지 정보를 중심으로 움직입니다.
- `path`: vault 기준 상대 경로
- `contentHash`: 파일 내용 해시
- `version`: slogs 원격 vault의 단조 증가 버전
플러그인이 파일을 올릴 때 기준 버전을 함께 보냅니다. 서버의 원격 파일이 그 이후 이미 바뀌었다면 slogs는 409 응답과 함께 `obsidianConflict`를 반환합니다.
플러그인은 충돌이 생긴 파일에 대해 `Use remote`, `Keep local`, `Skip` 선택지를 보여줍니다. 이 정책 때문에 “마지막 저장이 무조건 이김” 같은 위험한 덮어쓰기를 피할 수 있습니다.
## Windows Drive로 열기
Windows에서는 WinFsp 기반 Drive를 사용해 원격 vault를 로컬 파일시스템처럼 열 수 있습니다.
현재 공식 winget 소스 반영 전에는 다음 manifest 설치 명령을 사용합니다.
```powershell
$manifest = Join-Path $env:TEMP "SlogsObsidianDrive-winget"
Remove-Item $manifest -Recurse -Force -ErrorAction SilentlyContinue
New-Item -ItemType Directory -Force -Path $manifest | Out-Null
$base = "https://raw.githubusercontent.com/dimohy/slogs/main/packaging/winget/manifests/d/Dimohy/SlogsObsidianDrive/0.1.0"
@("Dimohy.SlogsObsidianDrive.yaml","Dimohy.SlogsObsidianDrive.locale.en-US.yaml","Dimohy.SlogsObsidianDrive.installer.yaml") | ForEach-Object {
Invoke-WebRequest "$base/$_" -OutFile (Join-Path $manifest $_)
}
winget install --manifest $manifest --accept-package-agreements --accept-source-agreements
```
winget-pkgs PR이 병합되고 사용자의 winget source index가 갱신된 뒤에는 다음 짧은 명령만으로 설치할 수 있습니다.
```powershell
winget install --id Dimohy.SlogsObsidianDrive --exact
```
설치 후 새 PowerShell을 열고 다음처럼 실행합니다.
```powershell
$env:SLOGS_OBSIDIAN_TOKEN = ""
SlogsObsidianDrive --server https://slogs.dev --vault "My Vault" --mount S:
```
Drive 설치기는 WinFsp 2026 `2.2.26112` 또는 호환 2.2 런타임이 없으면 공식 WinFsp GitHub Release에서 원격으로 내려받아 설치합니다. Drive의 Windows 용량 표시는 실제 PC 디스크 용량이 아니라 slogs 계정당 Obsidian 저장소 한도입니다. 기본값은 `1GB`이고, 사용 중인 공간은 현재 연결된 원격 vault의 활성 파일 크기 합계입니다.
설치와 옵션은 [Slogs Obsidian Drive 사용 가이드](/@dimohy/slogs-obsidian-drive-guide-20260629)에 따로 정리했습니다.
## 추천 사용 흐름
### 일상 노트 백업
`daily/`, `ideas/`, `meeting/` 같은 Markdown 폴더를 평소처럼 작성한 뒤 하루에 한 번 `Sync all Slogs files`를 실행합니다. 이 방식은 노트 구조를 크게 바꾸지 않고 원격 복사본을 유지하기 좋습니다.
### 글 초안 보관
Slogs 글로 발전시킬 초안을 Obsidian에서 먼저 씁니다. 공개 글로 연결할 노트에만 `slogs.post: true` frontmatter를 붙이고, 플러그인 설정에서 post 매핑을 켭니다.
### 여러 기기 작업
노트북에서 push하고 데스크톱에서 pull하는 식으로 사용할 수 있습니다. 단, 같은 파일을 두 기기에서 동시에 수정했다면 충돌이 날 수 있으니 먼저 pull한 뒤 편집하는 흐름이 안전합니다.
### Windows에서 Drive로 열기
Drive를 켜고 `S:` 같은 마운트 경로를 Obsidian vault로 엽니다. 이 방식은 Obsidian 플러그인을 설치하지 않아도 되며, 파일 탐색기나 다른 편집기에서도 같은 원격 vault를 다룰 수 있습니다.
## 문제 해결
| 증상 | 확인할 것 |
| --- | --- |
| 401 Unauthorized | 토큰을 입력했는지, 앞뒤 공백이 없는지 확인합니다. |
| 403 Forbidden | `mcp` 토큰을 넣은 경우입니다. `Obsidian 동기화` 용도 토큰을 새로 만드세요. |
| conflict 알림 | 원격 파일이 기준 버전 이후 변경된 상태입니다. 원격/로컬 내용을 비교한 뒤 선택하세요. |
| 아무 파일도 올라가지 않음 | 파일 확장자와 opt-in 설정을 확인합니다. 기본값은 Markdown 중심입니다. |
| 다른 원격 vault로 다시 연결하고 싶음 | 플러그인 설정의 `Reset local sync state`를 사용합니다. 로컬 파일과 원격 vault를 삭제하지 않고 클라이언트 cursor만 초기화합니다. |
| Drive 설치 중 WinFsp 권한 상승 창이 뜸 | WinFsp는 Windows 파일시스템 드라이버이므로 설치에 관리자 권한이 필요합니다. |
| Drive 마운트가 안 됨 | Windows인지, 드라이브 문자가 비어 있는지, `obsidian.sync` 토큰을 사용했는지 확인합니다. |
| Drive 용량이 1GB로 보임 | 정상입니다. Drive는 실제 PC 디스크가 아니라 slogs Obsidian 계정 한도를 볼륨 용량으로 표시합니다. |
## 한 줄 요약
Slogs Obsidian Sync는 Obsidian을 “로컬 Markdown 편집기”로 유지하면서 slogs 계정에 안전한 원격 vault를 추가하는 기능입니다. Obsidian 안에서는 커뮤니티 플러그인 `Slogs Sync` 0.1.2 이상을 쓰고, Windows 파일시스템처럼 열고 싶을 때는 GitHub Release 기반 winget manifest로 설치하는 [Slogs Obsidian Drive](/@dimohy/slogs-obsidian-drive-guide-20260629)를 쓰면 됩니다.
---
# Agent가 Slogs 글을 초안으로 저장하고 발행하는 방식
- Public log: https://slogs.dev/@dimohy/agent-slogs-mcp-publishing-20260627
- Markdown version: https://slogs.dev/@dimohy/agent-slogs-mcp-publishing-20260627.md
- Slogger home: @dimohy
- Published: 2026-06-27
- Updated: 2026-06-27
- Reading span: 11 minutes
- Tags: #slogs, #mcp, #markdown, #publishing, #agent
- Log series: Slogs LLM Wiki
- Representative image: https://slogs.dev/uploads/20260627-llmwiki-post-publishing-v2.png
## Summary
Slogs MCP의 글쓰기 도구가 초안 저장, 수정, 발행, 이미지 업로드를 어떻게 나누어 처리하는지 설명합니다.
## Knowledge-Log Body
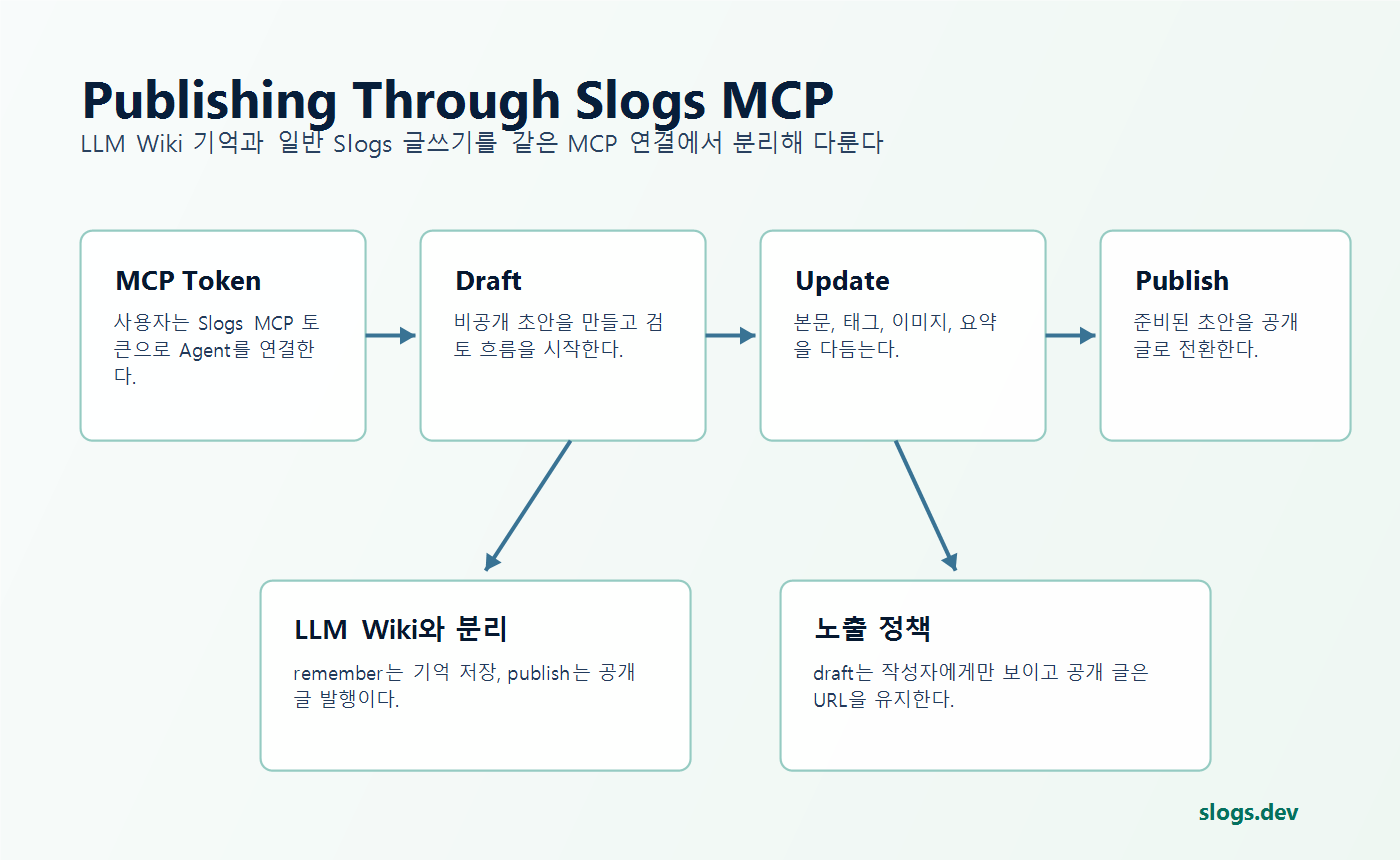
Agent가 블로그 글을 쓸 수 있게 만들 때 가장 먼저 정해야 할 것은 “바로 공개할 것인가, 먼저 저장할 것인가”다. 사람은 글을 쓰면서 자연스럽게 초안, 수정, 발행 단계를 구분한다. Agent에게도 같은 단계가 필요하다.
Slogs MCP 글쓰기 도구는 이 흐름을 명확히 나눈다.
- 이미지 업로드
- 초안 저장
- 초안 수정
- 공개 발행
- 공개 글 수정
- 글 읽기
이 구조 덕분에 Agent는 “작성 중인 글”과 “이미 공개된 글”을 다르게 다룰 수 있다.
## MCP 도구는 UI 버튼이 아니라 작업 계약이다
MCP에서 tool은 모델이 호출할 수 있는 서버 기능이다. Slogs 글쓰기 MCP도 단순한 API 래퍼가 아니라 Agent와 서버 사이의 작업 계약으로 본다.
예를 들어 `slogs_post_publish`는 공개 글을 만든다. 반면 `slogs_post_save_draft`는 공개 목록에 보이지 않는 pre-publish 상태의 글을 저장한다. 둘을 같은 도구로 뭉치면 Agent가 실수로 미완성 글을 공개할 가능성이 커진다.
도구를 나누는 이유는 Agent의 판단 부담을 줄이기 위해서다. 사용자가 “초안으로 저장해줘”라고 하면 저장 도구를 쓰고, “올려줘”라고 하면 발행 도구를 쓴다.
## 초안은 공개 글이 아니다
Slogs의 pre-publish 글은 작성자에게만 보인다. 공개 목록에도 나오지 않고, 공개 API에서도 일반 방문자에게 노출되지 않는다. 검색 엔진에 노출될 글도 아니다.
이 상태가 중요한 이유는 Agent가 긴 글을 만들 때 한 번에 완성하지 못할 수 있기 때문이다. 먼저 초안으로 저장하고, 사용자의 검토를 받은 뒤, 같은 slug를 대상으로 업데이트하고, 마지막에 발행할 수 있어야 한다.
기본 흐름은 이렇게 잡는다.
```text
save_draft -> read -> update -> publish
```
중간에 사용자가 방향을 바꾸면 update 단계에서 제목, 본문, 요약, 태그, 시리즈, 대표 이미지를 바꿀 수 있다.
## 공개된 글을 수정하면 revision이 된다
이미 공개된 글은 URL 안정성이 중요하다. 그래서 공개 글을 업데이트할 때는 기존 public URL을 유지하는 쪽이 안전하다.
Slogs MCP의 `slogs_post_update`와 `slogs_post_publish`는 소유한 글을 대상으로 동작한다. 이미 공개된 글이면 slug를 함부로 바꾸지 않고, 새 내용으로 revision을 낸다. 독자가 공유한 링크가 깨지지 않게 하기 위해서다.
반대로 아직 pre-publish 상태인 글은 `customSlug`를 조정할 수 있다. 공개 전이므로 최종 URL을 다듬을 여지가 있다.
## 이미지는 먼저 업로드하고 본문에 넣어야 한다
Markdown 글에서 이미지는 단순 장식이 아니다. 목록 카드, 대표 이미지, 본문 시각 구조에 모두 영향을 준다.
Slogs MCP는 로컬 또는 생성 이미지를 먼저 업로드하고, 반환된 `/uploads/...` URL을 Markdown 본문에 포함하도록 한다. 업로드된 이미지를 본문이나 대표 이미지에서 사용하지 않으면 다음 저장/수정/발행 시 미사용 이미지로 정리될 수 있다.
안전한 순서는 다음과 같다.
```text
upload_image -> markdown에 이미지 URL 삽입 -> save_draft 또는 publish
```
대표 이미지는 `thumbnailUrl`에 같은 `/uploads/...` 경로를 넣거나, 생략하면 본문의 첫 번째 이미지를 사용할 수 있다.
## Markdown은 공통 언어로 남겨둔다
Slogs 글쓰기 도구의 본문은 Markdown이다. Markdown을 유지하면 Agent, 웹 에디터, 사람이 같은 형식으로 글을 다룰 수 있다. CommonMark 같은 명세가 있는 것도 장점이다.
물론 실제 서비스에서는 Markdown만으로 끝나지 않는다. 서버는 렌더링, 이미지 추출, 링크 처리, 요약 생성, 읽기 시간 계산, 공개/비공개 상태를 함께 관리해야 한다. 그래도 Agent에게 넘기는 글쓰기 표면은 Markdown처럼 단순한 편이 좋다.
## Agent 글쓰기 도구를 만들 때의 체크리스트
Slogs MCP를 만들며 유용했던 기준은 다음과 같다.
- 초안 저장과 공개 발행을 분리한다.
- 공개 글의 URL 안정성을 지킨다.
- 이미지 업로드와 본문 참조를 하나의 흐름으로 묶는다.
- 글 읽기 도구를 제공해 Agent가 발행 결과를 다시 확인하게 한다.
- 작성자 인증과 소유권 검사를 서버에서 강제한다.
- 공개 글과 LLM Wiki 기억을 명확히 분리한다.
마지막 항목이 특히 중요하다. Slogs post는 사람에게 공개되는 글이고, LLM Wiki entry는 Agent가 다시 쓰기 위한 기억이다. 둘은 저장 목적도, 노출 범위도, 수정 규칙도 다르다.
## 참고 링크
- Model Context Protocol Tools: https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- CommonMark Markdown Spec: https://spec.commonmark.org/0.31.2/
- Slogs MCP Agent Prompt: https://slogs.dev/prompts/slogs-mcp.ko.md
---
# Agent 프롬프트를 매번 다시 읽지 않게 만드는 방법
- Public log: https://slogs.dev/@dimohy/agent-prompt-session-start-sync-20260627
- Markdown version: https://slogs.dev/@dimohy/agent-prompt-session-start-sync-20260627.md
- Slogger home: @dimohy
- Published: 2026-06-27
- Updated: 2026-06-27
- Reading span: 11 minutes
- Tags: #mcp, #agent, #prompt, #sync, #slogs
- Log series: Slogs LLM Wiki
- Representative image: https://slogs.dev/uploads/20260627-llmwiki-prompt-sync-v2.png
## Summary
Slogs MCP 프롬프트 동기화를 주기 스케줄이 아니라 세션 시작 버전 체크로 설계한 이유와 구현 규칙을 정리합니다.
## Knowledge-Log Body
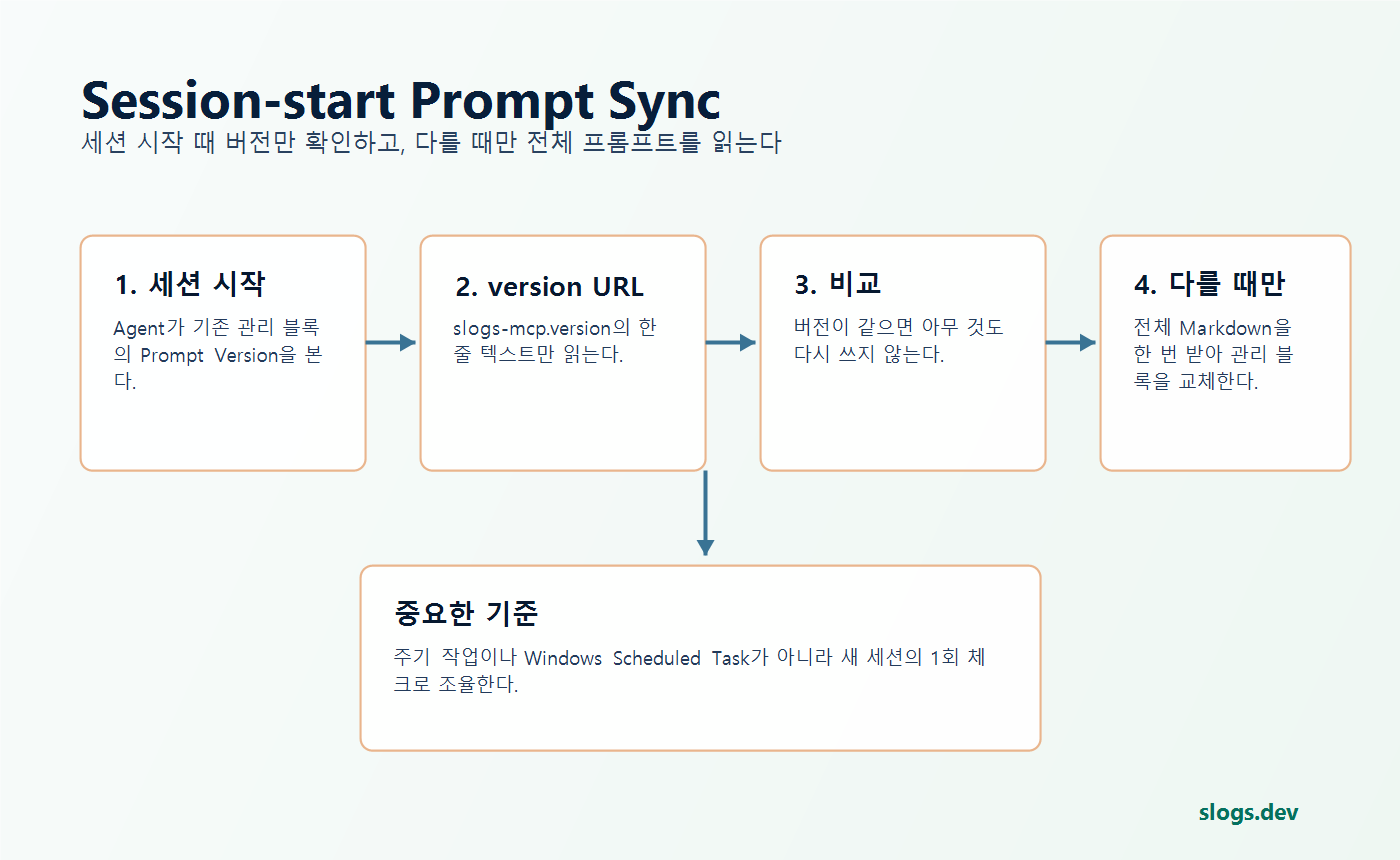
Agent 정책 프롬프트는 길어지기 쉽다. 처음에는 설치 안내, MCP 연결 방법, 기억 조회 규칙, 저장 규칙, 예외 상황까지 모두 넣어야 하므로 자연스럽다. 문제는 이 프롬프트가 전역 `AGENTS.md` 같은 영구 지침에 들어가면 매 세션마다 토큰을 잡아먹는다는 점이다.
Slogs MCP 프롬프트도 같은 문제를 겪었다. 기능은 유지해야 하지만, 전역 Agent 정책은 훨씬 작아져야 했다. 그래서 Slogs는 “전체 프롬프트를 매번 읽는 방식”이 아니라 “세션 시작 시 버전만 확인하는 방식”으로 바꿨다.
## 목표는 압축이지 기능 삭제가 아니다
프롬프트를 compact하게 만든다고 해서 정책을 삭제하면 안 된다. 줄여야 하는 것은 중복 설명이고, 유지해야 하는 것은 동작 계약이다.
Slogs MCP 프롬프트에서 유지해야 했던 핵심 계약은 다음과 같다.
- 처음 설치 시 MCP 키를 다시 묻는 조건
- 전역/프로젝트/현재 세션 적용 범위 선택
- 토큰을 문서, 로그, LLM Wiki에 기록하지 않는 규칙
- 이전 결정/선호/프로젝트 맥락은 LLM Wiki를 먼저 조회하는 규칙
- 저장 전 관련 기억을 찾고 병합/갱신하는 규칙
- categoryPath를 명시하는 규칙
- 프롬프트 버전 동기화 규칙
compact 버전은 이 계약을 짧게 표현할 뿐, 기능을 줄이지 않는다.
## 세션 시작에는 한 줄 버전만 확인한다
핵심은 `slogs-mcp.version` 엔드포인트다.
세션이 시작되면 Agent나 동기화 스크립트는 먼저 다음 URL의 한 줄 버전 텍스트만 읽는다.
```text
https://slogs.dev/prompts/slogs-mcp.version
```
그 다음 로컬 지침 파일에 설치된 `SLOGS_MCP_PROMPT` 관리 블록의 version과 비교한다.
- 버전이 같으면 전체 프롬프트를 읽지 않는다.
- 파일을 다시 쓰지 않는다.
- 키 요청을 반복하지 않는다.
- 적용 범위 질문도 반복하지 않는다.
이 규칙 하나로 평소 세션 시작 비용이 작아진다. 대부분의 세션에서는 한 줄 버전 확인만 하고 기존 정책으로 바로 작업하면 된다.
## 버전이 다를 때만 전체 Markdown을 읽는다
서버 버전과 로컬 버전이 다르거나, 로컬 블록에 버전이 없을 때만 전체 프롬프트를 읽는다.
```text
https://slogs.dev/prompts/slogs-mcp.ko.md
```
읽은 뒤에는 기존 `SLOGS_MCP_PROMPT` 관리 블록을 같은 위치에서 교체한다. 전역에 설치된 블록은 전역 지침에서, 프로젝트에 설치된 블록은 프로젝트 지침에서 갱신한다.
중요한 점은 누적 추가가 아니라 교체라는 것이다. 같은 정책이 여러 번 붙으면 Agent는 어떤 문장을 더 우선해야 하는지 알기 어렵다. 관리 블록은 하나만 있어야 한다.
## 이것은 스케줄러가 아니다
처음에는 `SlogsMcpPromptSync`라는 이름 때문에 주기적 스케줄처럼 보일 수 있었다. 하지만 의도는 백그라운드 스케줄이 아니다.
Slogs의 현재 정책은 명확하다.
- Windows Scheduled Task로 반복 등록하지 않는다.
- 일정 시간마다 자동 갱신하지 않는다.
- 세션 시작 시 버전이 다를 때만 동기화한다.
- 버전이 같으면 전체 프롬프트를 fetch하지 않는다.
Agent 정책은 사용자가 작업을 시작하는 시점에 맞춰 최신이면 충분하다. 백그라운드에서 몰래 지침 파일을 바꾸면 디버깅이 어려워지고, 사용자가 보지 않는 시점에 정책이 변할 수 있다.
## 해시와 관리 블록이 필요한 이유
Slogs 관리 블록은 URL, version, sha256, updated 값을 헤더에 둔다. 버전만으로도 동기화 판단은 가능하지만, 해시는 실제 본문이 기대한 내용인지 검증하는 데 도움이 된다.
관리 블록의 목적은 사람이 읽기 위한 장식이 아니다. Agent와 스크립트가 다음을 명확히 알기 위한 구조다.
- 이 블록은 Slogs MCP 프롬프트가 관리한다.
- 현재 설치된 버전은 무엇이다.
- 서버와 비교할 URL은 무엇이다.
- 새 버전이 오면 이 블록만 교체하면 된다.
## Agent 정책은 짧을수록 좋지만 모호하면 안 된다
프롬프트를 줄일 때 흔한 실수는 예외 규칙을 잘라내는 것이다. 하지만 실제 운영에서 중요한 부분은 대부분 예외다.
- MCP 도구가 보이지 않을 때는 tool search를 먼저 시도한다.
- 도구가 없으면 기억을 사용했다고 말하지 않는다.
- 토큰을 평문 설정에 써야 하면 먼저 사용자에게 알린다.
- 민감 정보는 LLM Wiki에 저장하지 않는다.
- 기억 저장은 remember보다 merge/update가 우선이다.
compact 프롬프트는 이런 규칙을 살리면서 설명을 줄여야 한다. 짧아졌는데 Agent 행동이 달라졌다면 실패한 압축이다.
## 참고 링크
- Slogs MCP prompt version: https://slogs.dev/prompts/slogs-mcp.version
- Slogs MCP Korean prompt: https://slogs.dev/prompts/slogs-mcp.ko.md
- Model Context Protocol Tools: https://modelcontextprotocol.io/specification/2025-06-18/server/tools
---
# Slogs LLM Wiki 검색은 어떻게 기억을 찾아내는가
- Public log: https://slogs.dev/@dimohy/slogs-llm-wiki-graphrag-20260627
- Markdown version: https://slogs.dev/@dimohy/slogs-llm-wiki-graphrag-20260627.md
- Slogger home: @dimohy
- Published: 2026-06-27
- Updated: 2026-06-27
- Reading span: 13 minutes
- Tags: #llm wiki, #graphrag, #pgvector, #embedding, #search
- Log series: Slogs LLM Wiki
- Representative image: https://slogs.dev/uploads/20260627-llmwiki-graphrag-v2.png
## Summary
Slogs LLM Wiki의 검색 흐름을 EmbeddingGemma, pgvector, 그래프 신호, Retrieval Diagnostics 관점에서 설명합니다.
## Knowledge-Log Body
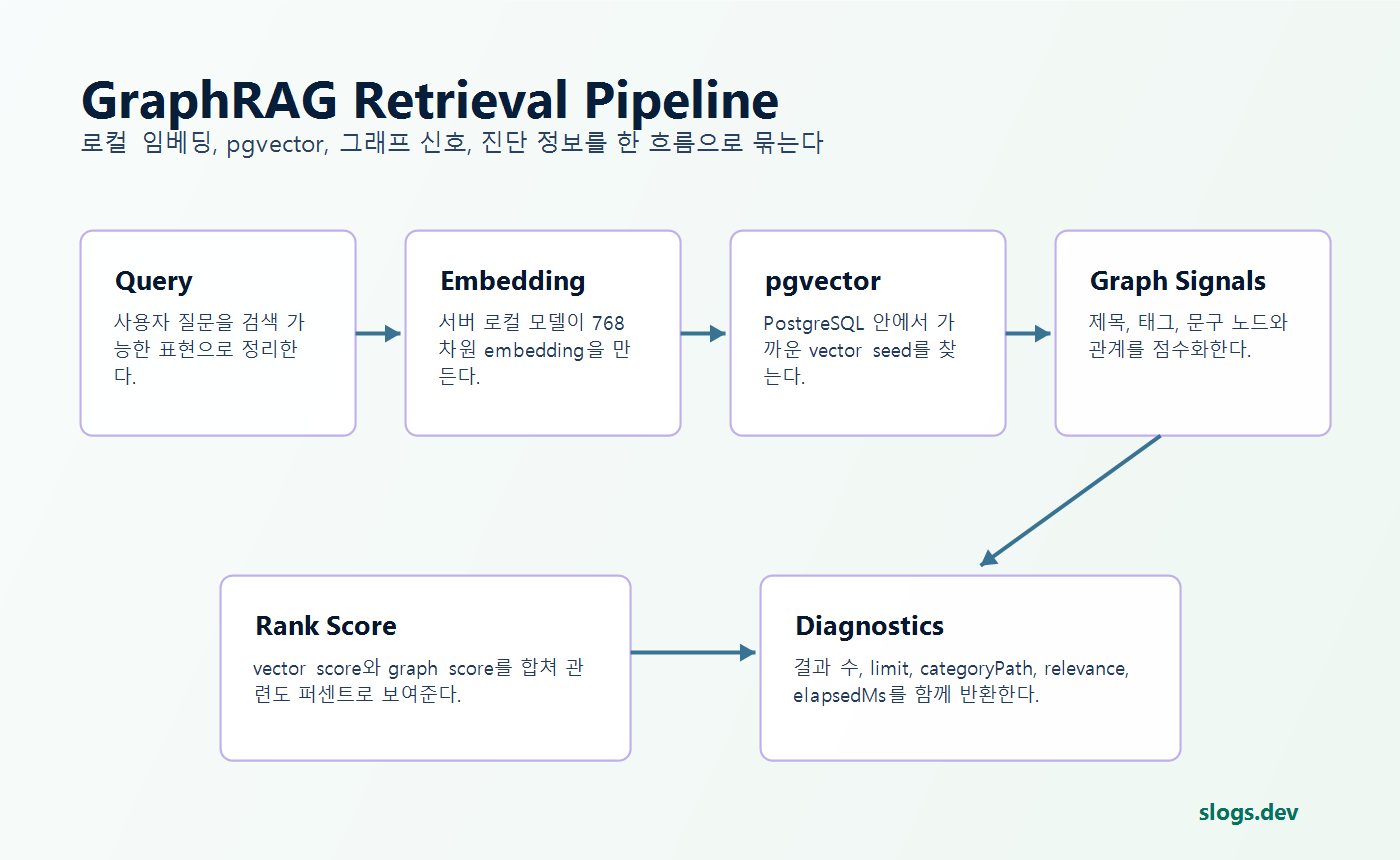
LLM Wiki에서 검색은 단순히 “키워드가 들어간 문서를 찾는 일”이 아니다. Agent가 다음 행동에 쓸 수 있는 기억을 찾아야 한다. 그래서 Slogs LLM Wiki의 검색은 세 가지 신호를 함께 본다.
- 사용자의 질문이 어떤 의미를 갖는지
- 저장된 기억의 의미 벡터가 얼마나 가까운지
- 기억 사이의 카테고리, 태그, 관련 항목 연결이 어떤 그래프를 이루는지
이 글에서는 Slogs LLM Wiki의 검색 흐름을 GraphRAG 관점으로 정리한다.
## 1. 질문을 임베딩으로 바꾼다
검색의 첫 단계는 질문을 임베딩 벡터로 바꾸는 것이다. Slogs에서는 서버 로컬의 EmbeddingGemma 모델을 사용하도록 정책을 잡았다. 외부 hosted API에 매번 보내는 구조가 아니라, 서버 내부에서 재현 가능한 임베딩을 만들기 위해서다.
이 선택에는 장점이 있다.
- API 키가 검색 경로에 끼지 않는다.
- 로컬 운영 환경에서 검색 품질을 반복 측정하기 쉽다.
- 장애 원인이 네트워크/API/과금 이슈로 퍼지지 않는다.
물론 로컬 모델을 쓰면 배포 크기와 초기 로딩 시간이 늘어난다. 그래서 Slogs는 모델 호출을 핵심 경로로 인정하고, 실패 시 조용히 다른 검색으로 우회하는 방식을 피한다. 검색 품질을 보장하려면 실패가 드러나야 한다.
## 2. pgvector로 가까운 기억 후보를 고른다
임베딩이 만들어지면 PostgreSQL의 pgvector를 통해 가까운 기억 후보를 찾는다. pgvector는 PostgreSQL 안에서 vector 타입과 유사도 검색을 사용할 수 있게 해주는 확장이다.
이 단계는 seed retrieval에 가깝다. 처음부터 “정답”을 하나 고르는 것이 아니라, 의미적으로 가까운 후보 묶음을 만든다.
후보를 너무 많이 가져오면 Agent에 전달되는 문맥이 커지고, 너무 적게 가져오면 중요한 기억이 빠진다. 그래서 Slogs MCP 도구는 기본 limit을 작게 잡고, 필요할 때만 좁은 query/categoryPath/minRelevancePercent로 다시 조회하게 한다.
## 3. 그래프 신호로 후보를 다시 본다
GraphRAG의 핵심 아이디어는 문서 조각을 벡터로만 보지 않고, 지식 간의 관계를 함께 활용하는 데 있다. Slogs LLM Wiki도 이 방향을 따른다.
예를 들어 어떤 기억이 `slogs/llm-wiki/graphrag` 카테고리에 있고, 다른 기억이 `slogs/deployment/wasm-aot`에 있다면 둘은 모두 Slogs 프로젝트 기억이지만 적용 맥락은 다르다. 같은 단어가 들어 있어도 categoryPath가 다르면 Agent가 다르게 해석해야 한다.
그래서 categoryPath는 단순 분류 라벨이 아니다. 검색 범위를 좁히고, 기억의 적용 영역을 판단하는 구조 정보다.
좋은 categoryPath는 대체로 이렇게 생겼다.
```text
project/domain/topic
project/feature/decision
preference/domain/project
codex/mcp/slogs
```
반대로 `general`, `misc`, `notes` 같은 경로는 나중에 검색을 어렵게 만든다. 주제를 알 수 있으면 구체적으로 저장해야 한다.
## 4. Retrieval Diagnostics로 검색 품질을 본다
Agent 검색에서 가장 위험한 상황은 “검색을 했지만 사실상 실패한 것”을 성공으로 착각하는 것이다. 결과가 0개였거나, 상위 결과가 엉뚱하거나, 너무 넓은 범위를 훑어서 쓸모없는 문맥만 가져왔는데도 Agent가 그럴듯하게 답하면 기억 시스템은 오히려 위험해진다.
그래서 Slogs LLM Wiki 응답에는 Retrieval Diagnostics를 붙인다.
- result count
- effectiveLimit
- categoryPath
- minRelevancePercent
- elapsedMs
Agent는 이 값을 보고 조회가 충분했는지 판단해야 한다. 결과가 부실하면 query를 바꾸거나, categoryPath를 좁히거나, limit을 조정해서 다시 조회한다. 검색이 느리거나 결과가 너무 크면 그 자체도 신호다.
## 5. search와 recall은 다르게 쓴다
Slogs MCP에서 `llm_wiki_search`와 `llm_wiki_recall`은 일부러 역할이 다르다.
`search`는 후보 선별 도구다. 제목, 요약, 태그, categoryPath 정도만 보고 “무엇을 읽을지”를 고른다.
`recall`은 실제 답변이나 구현에 적용할 compact context를 가져온다. 그래서 더 많은 문맥을 반환하지만, 기본 limit은 작게 유지하는 편이 좋다.
전체 원문이나 raw provenance가 필요하면 `read`를 쓴다. 이렇게 해야 Agent가 필요한 만큼만 읽고, 근거가 필요한 순간에는 정확한 항목을 열 수 있다.
## 운영 관점의 결론
GraphRAG는 화려한 이름보다 운영 규칙이 중요하다. Slogs LLM Wiki에서 실제로 중요했던 것은 다음 네 가지였다.
- 로컬 임베딩 모델을 검색의 공식 경로로 둔다.
- pgvector로 의미 후보를 안정적으로 뽑는다.
- categoryPath와 관련 항목을 그래프 신호로 쓴다.
- Retrieval Diagnostics로 검색 품질을 Agent가 판단하게 한다.
이 구조가 있어야 Agent는 “기억을 검색했다”에서 멈추지 않고, “쓸 수 있는 기억을 회수했다”에 가까워진다.
## 참고 링크
- Microsoft GraphRAG: https://microsoft.github.io/graphrag/
- pgvector: https://github.com/pgvector/pgvector
- EmbeddingGemma: https://ai.google.dev/gemma/docs/embeddinggemma
- Ollama API: https://github.com/ollama/ollama/blob/main/docs/api.md
---
# LLM Wiki는 메모장이 아니라 Agent의 작업 기억이다
- Public log: https://slogs.dev/@dimohy/llm-wiki-agent-memory-20260627
- Markdown version: https://slogs.dev/@dimohy/llm-wiki-agent-memory-20260627.md
- Slogger home: @dimohy
- Published: 2026-06-27
- Updated: 2026-06-27
- Reading span: 11 minutes
- Tags: #llm wiki, #agent, #mcp, #slogs, #memory
- Log series: Slogs LLM Wiki
- Representative image: https://slogs.dev/uploads/20260627-llmwiki-agent-memory-v2.png
## Summary
Slogs LLM Wiki가 단순 메모장이 아니라 Agent가 조회, 판단, 저장을 반복하는 작업 기억 계층으로 동작하는 방식을 정리합니다.
## Knowledge-Log Body
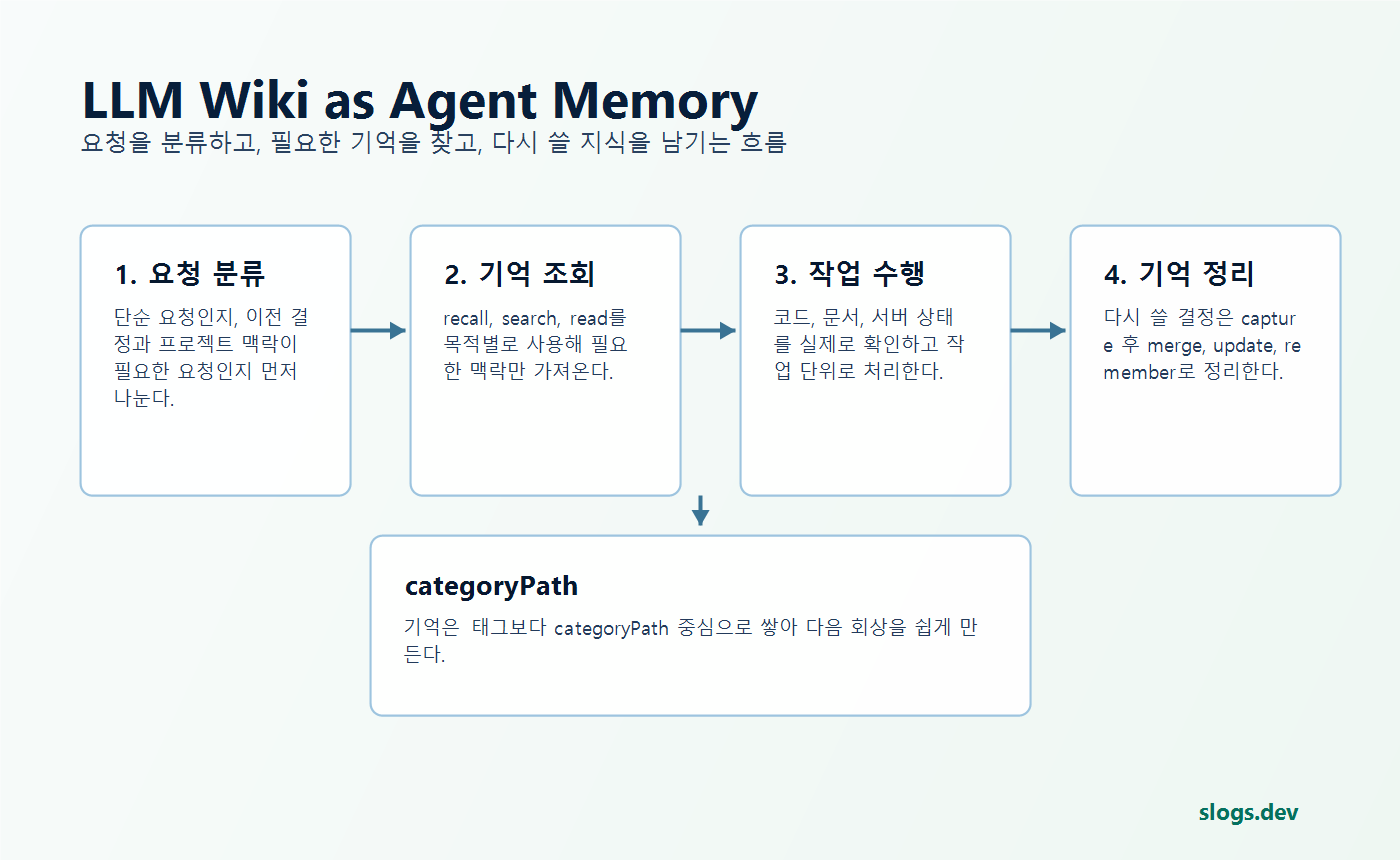
LLM Wiki를 처음 만들 때 가장 경계해야 할 오해는 이것을 “AI가 보는 메모장” 정도로 보는 것이다. 메모장은 사람이 나중에 읽기 위해 남긴다. Agent의 작업 기억은 다르다. Agent가 현재 요청을 처리하기 전에 먼저 조회하고, 조회 결과를 기준으로 판단하고, 작업이 끝난 뒤 다음 세션에도 재사용할 지식을 다시 정리해 넣는 실행 경로의 일부다.
Slogs LLM Wiki는 이 관점으로 설계했다. 글 하나를 저장하는 기능보다 중요한 것은 Agent가 언제 검색해야 하는지, 어떤 도구를 써야 하는지, 어떤 정보는 저장하지 말아야 하는지를 정책으로 고정하는 것이다.
## 기억이 필요한 질문과 필요 없는 질문
모든 요청을 기억 서버로 보내면 느려지고 노이즈가 쌓인다. 반대로 기억을 거의 조회하지 않으면 매 세션이 처음 만난 사람처럼 행동한다.
그래서 기준을 단순하게 둔다.
- 현재 시각 확인, 짧은 번역, 일회성 명령처럼 맥락이 필요 없는 요청은 바로 처리한다.
- 이전 결정, 사용자 선호, 프로젝트 판단 기준, 작업 재시작 지점, 반복 워크플로가 영향을 줄 수 있으면 먼저 LLM Wiki를 조회한다.
- 결과가 애매하면 로컬 파일이나 코드보다 기억 후보를 먼저 보고, 그 다음 실제 파일로 검증한다.
이 순서가 중요하다. 코드 저장소에는 “현재 구현”은 남아 있지만, 왜 그렇게 결정했는지나 사용자가 싫어하는 방식은 남아 있지 않을 때가 많다. 예를 들어 “fallback 구현을 싫어한다”는 선호는 코드만 봐서는 알 수 없다. 이런 기준은 Agent가 작업 전에 반드시 회수해야 한다.
## 도구는 역할별로 나뉘어야 한다
MCP 공식 문서에서 도구는 모델이 발견하고 호출할 수 있는 외부 기능으로 설명된다. Slogs LLM Wiki도 이 구조를 따른다. 다만 모든 조회를 하나의 search로 해결하지 않는다.
- `llm_wiki_search`: 제목, 요약, 태그, categoryPath로 후보를 작게 고르는 도구
- `llm_wiki_recall`: 답변이나 구현에 바로 반영할 compact context를 회수하는 도구
- `llm_wiki_read`: 선택한 항목의 전체 내용과 출처를 읽는 도구
- `llm_wiki_capture`, `llm_wiki_find_related`: 저장 전에 관련 기억을 찾고 병합 후보를 판단하는 도구
- `llm_wiki_merge`, `llm_wiki_update`, `llm_wiki_remember`: 기존 기억을 갱신하거나 새 기억을 저장하는 도구
이 분리는 토큰 비용을 줄이는 목적만 있는 것이 아니다. Agent가 “대충 검색해서 나온 문장”과 “정말 적용해야 하는 기억”을 구분하게 만든다.
## 좋은 기억은 재사용 가능한 판단이다
Slogs LLM Wiki에 저장할 만한 정보는 단순 실행 로그가 아니다. “방금 배포했다”, “어떤 명령을 실행했다” 같은 일회성 진행상황은 대부분 저장 가치가 낮다.
반대로 다음과 같은 정보는 장기 기억으로 가치가 있다.
- 사용자가 명시적으로 정정한 용어와 판단 기준
- 프로젝트에서 반복되는 운영 절차
- 코드만 보고는 알기 어려운 전제조건
- 장애 원인과 검증된 해결 경로
- 다음 세션에서 바로 이어갈 수 있는 재시작 지점
- 나중에 runbook이나 자동화로 바꿀 수 있는 명령 흐름
핵심은 “나중의 Agent가 이 정보를 보고 더 나은 결정을 할 수 있는가”다. 그렇지 않다면 저장하지 않는 편이 낫다.
## 저장보다 병합이 중요하다
기억 시스템이 오래 가려면 새 항목을 무한히 쌓는 방식은 피해야 한다. 같은 주제의 결정이 여러 개로 흩어지면 검색 결과는 많아지지만 실제 판단은 어려워진다.
Slogs LLM Wiki는 저장 전에 관련 항목을 먼저 찾도록 한다. 관련 항목이 있으면 읽고, 기존 기억에 병합하거나 갱신한다. 관련 항목이 없을 때만 새 항목을 만든다.
이때 raw provenance도 중요하다. 읽기 좋은 통합 기억은 필요하지만, 처음 어떤 요청에서 나온 결정인지도 남아 있어야 한다. 그래야 나중에 검색 품질이나 병합 품질을 점검할 수 있다.
## 운영 체크리스트
Agent 기억 서버를 만들 때는 기능보다 운영 규칙을 먼저 정해야 한다.
- 조회와 저장 도구를 분리한다.
- 저장 전 관련 기억 탐색을 강제한다.
- 민감 정보, API 키, 토큰, 일회성 로그는 저장하지 않는다.
- categoryPath를 필수에 가깝게 사용한다.
- 검색 결과의 품질 진단값을 확인한다.
- 기억을 사용하지 못했으면 사용했다고 말하지 않는다.
이 규칙들이 있어야 LLM Wiki가 “많이 저장된 메모장”이 아니라 Agent의 작업 기억으로 동작한다.
## 참고 링크
- Model Context Protocol Tools: https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- CommonMark Markdown Spec: https://spec.commonmark.org/0.31.2/
- Slogs MCP Agent Prompt: https://slogs.dev/prompts/slogs-mcp.ko.md
---
# Slogs LLM Wiki 사용법 완전 가이드
- Public log: https://slogs.dev/@dimohy/slogs-llm-wiki-guide-20260624
- Markdown version: https://slogs.dev/@dimohy/slogs-llm-wiki-guide-20260624.md
- Slogger home: @dimohy
- Published: 2026-06-24
- Updated: 2026-06-29
- Reading span: 81 minutes
- Tags: #slogs, #llm-wiki, #mcp, #ai-agent, #graphrag
- Log series: slogs 사용 가이드
- Representative image: https://slogs.dev/uploads/20260624-llm-wiki-guide-usage.webp
## Summary
Slogs LLM Wiki를 UI와 MCP Agent 양쪽에서 사용하는 방법을 설치, 검색, 회상, 저장, 병합, Raw Provenance, categoryPath, 검색 품질 점검까지 스크린샷과 함께 정리하였습니다.
## Knowledge-Log Body
# Slogs LLM Wiki 사용법 완전 가이드
> 2026.06.24 기준으로 정리한 Slogs LLM Wiki 사용 안내입니다. 이 글은 사람이 직접 Slogs 화면에서 Wiki를 검색하는 방법과, Codex·Claude·GitHub Copilot 같은 AI Agent가 Slogs MCP를 통해 장기 기억을 조회하고 저장하는 방법을 함께 다룹니다.
Slogs LLM Wiki는 단순한 메모장이 아닙니다. AI Agent가 이전 결정, 사용자 선호, 판단 기준, 프로젝트 맥락, 작업 기억을 다시 찾아 쓰도록 만든 개인 지식 저장소입니다. 한 번의 채팅 안에서만 유지되는 기억이 아니라, 다음 세션과 다른 Agent에서도 재사용할 수 있는 “검증 가능한 장기 기억”을 만드는 것이 목적입니다.
핵심은 세 가지입니다.
1. 기억할 만한 정보를 자연어로 남긴다.
2. Slogs가 그 정보를 GraphRAG 검색 가능한 Wiki 항목으로 인덱싱한다.
3. AI Agent가 필요한 순간 `search`, `recall`, `read`, `remember`, `merge`, `update` 같은 MCP 도구로 그 기억을 다시 사용한다.
이 글을 끝까지 읽으면 Slogs LLM Wiki를 다음과 같이 운영할 수 있습니다.
- 내 Slogs 화면에서 LLM Wiki 항목을 검색하고 읽는다.
- Agent에게 붙여넣을 Slogs MCP 정책 프롬프트를 얻는다.
- Slogs MCP 토큰과 엔드포인트를 설정한다.
- Agent가 언제 `search`를 쓰고 언제 `recall`을 써야 하는지 구분한다.
- 새 기억을 저장하기 전에 중복을 찾고, 기존 기억에 병합한다.
- `categoryPath`로 기억을 정리한다.
- Raw Provenance로 기억의 출처와 병합 이력을 검증한다.
- 검색 품질이 나쁠 때 query, categoryPath, limit, minRelevancePercent를 조정한다.
---
## 1. Slogs LLM Wiki가 해결하려는 문제
AI Agent를 쓰다 보면 같은 설명을 반복하게 됩니다.
- “이 프로젝트는 AOT 배포가 기본이 아니야.”
- “내가 선호하는 용어는 이 표현이 아니라 저 표현이야.”
- “이 오류는 지난번에 이 경로로 해결했어.”
- “이 작업은 먼저 이 파일을 읽고, 그 다음 이 스크립트를 실행해야 해.”
- “이 사용자는 이런 방식의 fallback 구현을 싫어해.”
일반 채팅 기록만으로는 이런 맥락을 안정적으로 이어가기 어렵습니다. 새 세션이 열리거나 Agent가 달라지면 이전 판단 기준을 모를 수 있습니다. 로컬 문서에 적어둘 수도 있지만, Agent가 언제 어떤 문서를 먼저 봐야 하는지 보장하기 어렵고, 프로젝트를 넘나드는 선호나 장기 운영 규칙은 더 흩어지기 쉽습니다.
Slogs LLM Wiki는 이 문제를 “Agent가 조회할 수 있는 장기 기억”으로 풀려고 합니다. 사람이 직접 작성한 문서라기보다, Agent와 사용자가 함께 쌓아가는 작업 기억 저장소입니다.
좋은 LLM Wiki 항목은 이런 성격을 가집니다.
- 나중에 다시 사용할 가능성이 있다.
- 단순 로그가 아니라 판단 기준이나 재현 가능한 지식이다.
- 현재 파일만 읽어서는 알기 어려운 배경이 들어 있다.
- 다른 Agent가 작업을 이어받을 때 도움이 된다.
- 저장 후에도 출처를 추적할 수 있다.
반대로 다음 정보는 LLM Wiki에 넣지 않는 것이 좋습니다.
- API 키, 비밀번호, 토큰 같은 민감 정보
- 일회성 로그 전문
- 임시 실행 내역
- 검증되지 않은 추측
- 현재 코드나 문서에서 쉽게 다시 확인할 수 있는 단순 사실
- 이번 턴 안에서만 의미 있는 중간 상태
---
## 2. Slogs LLM Wiki의 기본 구조
Slogs LLM Wiki 항목은 크게 다음 정보를 가집니다.
- 제목
- Source Prompt
- Content
- 태그
- categoryPath
- 생성/갱신 시각
- 열람 횟수
- Raw Provenance
### Source Prompt
Source Prompt는 기억의 핵심 원문에 가깝습니다. 사용자가 정정한 표현, Agent가 저장해야 한다고 판단한 운영 규칙, 구현 결과의 의미 등이 들어갑니다.
예를 들면 이런 내용입니다.
```text
Slogs 배포 선호: 일반 서버 반영 요청에는 WebAssembly AOT 없이 scripts/Deploy-Slogs.ps1를 실행한다. 사용자가 명시적으로 AOT 배포를 요청할 때만 -WasmAot를 사용한다.
```
### Content
Content는 현재 통합된 설명입니다. 처음 저장된 기억이 나중에 병합되거나 보강되면 Content는 더 읽기 좋은 형태로 정리됩니다.
예를 들어 처음에는 “AOT 쓰지 마”라는 짧은 정정이었더라도, 나중에는 배포 스크립트 이름, 검증 방식, 관련 릴리스 기록까지 포함한 운영 메모가 될 수 있습니다.
### Raw Provenance
Raw Provenance는 원래 저장 요청과 이후 merge/update 요청의 원문 근거입니다. LLM Wiki가 중요한 이유는 기억을 예쁘게 요약하는 데서 끝나지 않고, 그 요약이 어디에서 왔는지 추적할 수 있게 한다는 점입니다.
기억은 시간이 지나며 정제됩니다. 하지만 정제 과정에서 원래 의미가 왜곡되면 안 됩니다. Raw Provenance는 다음 질문에 답할 수 있게 해 줍니다.
- 이 기억은 처음 어떤 요청에서 만들어졌는가?
- 누가 어떤 내용으로 merge/update했는가?
- 현재 Content가 원래 근거와 맞는가?
- 검색 품질이 낮을 때 어떤 원문이 인덱싱되어 있었는가?
### categoryPath
`categoryPath`는 기억의 위치를 나타내는 경로입니다. 태그보다 더 중요한 구조 정보입니다.
예시는 다음과 같습니다.
```text
slogs/llm-wiki/graphrag
slogs/deployment/releases
slogs/ui/profile-hero
preference/memory/slogs
codex/mcp/slogs
lingomotion/youtube/metadata
```
가능하면 2-4개의 slash-separated segment를 쓰는 것이 좋습니다.
```text
project/domain/topic
project/feature/decision
preference/domain/project
codex/mcp/slogs
```
`general`, `misc`, `notes` 같은 모호한 경로는 피하는 것이 좋습니다. 나중에 검색 범위를 좁힐 수 없기 때문입니다.
---
## 3. Slogs 화면에서 LLM Wiki 사용하기
Slogs에 로그인하면 개인 영역에서 LLM Wiki를 사용할 수 있습니다.
현재 주요 경로는 두 개입니다.
- `/me/llm-wiki`: LLM Wiki 사용법과 Agent 프롬프트 페이지
- `/me/llm-wiki/search`: LLM Wiki 검색과 읽기 페이지
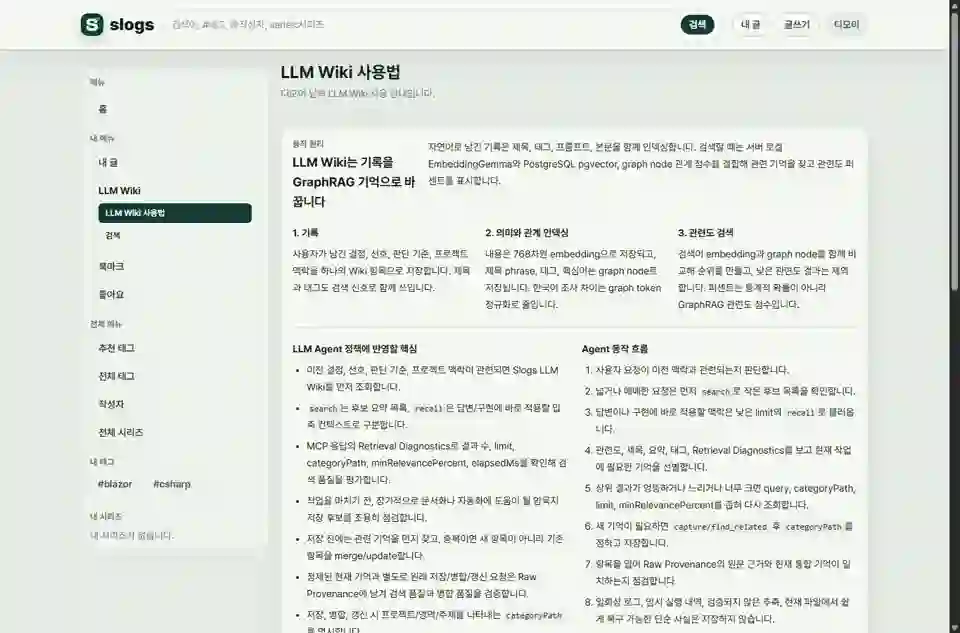
_사용법 페이지는 LLM Wiki 개념, Agent 정책 프롬프트, 버전 확인 흐름을 한 화면에서 확인하도록 분리되어 있습니다._
예전처럼 한 페이지 안에서 `#usage`, `#search`로 이동하는 구조가 아니라, 사용법과 검색이 분리된 페이지입니다. 따라서 Agent나 사용자 문서에서도 두 페이지를 명확히 구분하는 것이 좋습니다.
### 3.1. 사용법 페이지
`/me/llm-wiki`는 안내 페이지입니다. 여기에는 다음 정보가 있습니다.
- LLM Wiki가 GraphRAG 기억으로 동작하는 방식
- Agent가 지켜야 할 조회/저장 정책
- 한국어 Agent 프롬프트
- English Agent Prompt
- 프롬프트 버전 URL
- 프롬프트 복사 버튼
이 페이지에서 중요한 것은 “프롬프트를 복사해 Agent에 넣는 것”입니다. 복사되는 프롬프트는 단순히 “Slogs를 써라” 정도가 아니라, Agent가 언제 Slogs LLM Wiki를 조회하고, 언제 저장하고, 어떻게 중복을 병합해야 하는지까지 포함합니다.
프롬프트 URL은 다음과 같습니다.
```text
한국어: https://slogs.dev/prompts/slogs-mcp.ko.md
English: https://slogs.dev/prompts/slogs-mcp.en.md
한국어 호환 URL: https://slogs.dev/prompts/slogs-mcp.md
버전 URL: https://slogs.dev/prompts/slogs-mcp.version
```
프롬프트 동기화의 원칙은 “매번 전체 프롬프트를 다시 받지 않는다”입니다. Agent나 동기화 스크립트는 먼저 version URL의 한 줄 텍스트만 확인합니다. 로컬에 설치된 프롬프트 버전과 서버 버전이 같으면 전체 Markdown을 다시 읽지 않고, 키 요청이나 범위 선택도 반복하지 않습니다.
### 3.2. 검색 페이지
`/me/llm-wiki/search`는 저장된 기억을 직접 검색하고 읽는 페이지입니다.
검색 페이지에는 다음 UI가 있습니다.
- 검색어 입력창
- categoryPath 필터
- Wiki 카드 그리드
- 관련도 퍼센트
- 태그 표시
- 업데이트 시각
- 열람 횟수
- 상세 모달
- Raw Provenance 표시
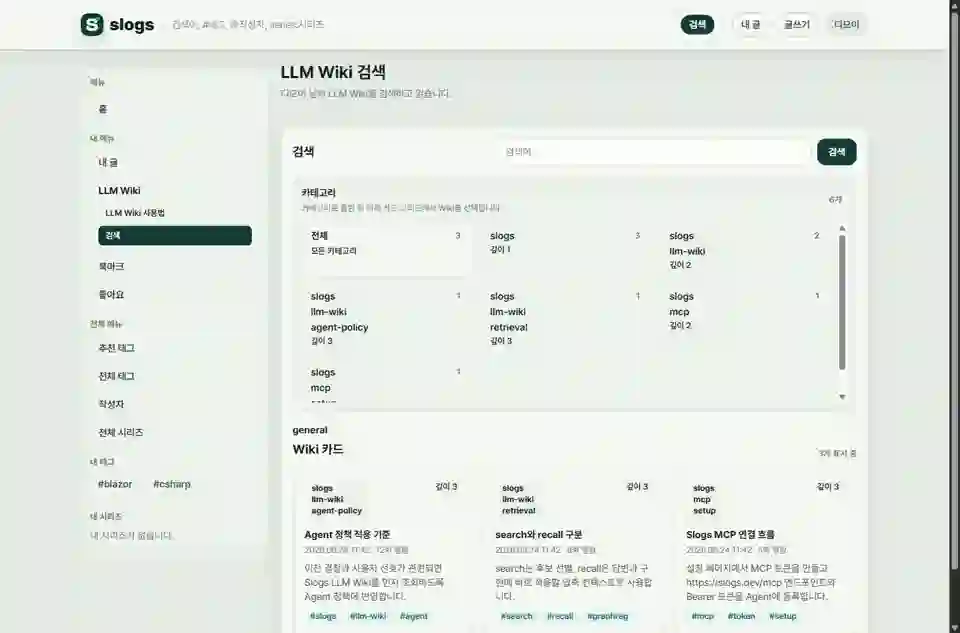
_검색 페이지는 categoryPath, 관련도 퍼센트, 카드형 결과를 통해 저장된 기억을 빠르게 검토하도록 구성되어 있습니다._
검색어 없이 전체 항목을 둘러볼 수도 있고, 특정 단어로 검색할 수도 있습니다. categoryPath를 클릭하면 해당 경로와 하위 맥락으로 좁혀 볼 수 있습니다.
카테고리 표시는 `slogs / llm-wiki / graphrag`처럼 한 줄로 길게 늘어지는 대신, 깊이별 줄 단위로 표시됩니다. 좁은 카드에서도 경로를 읽기 쉽게 하기 위한 설계입니다. 전체 경로는 hover hint로 확인할 수 있습니다.
상세 모달을 열면 현재 통합 기억뿐 아니라 Raw Provenance도 볼 수 있습니다. 기억을 사람이 직접 검토할 때는 이 부분이 중요합니다. “현재 요약이 그럴듯한가?”보다 “원문 근거와 맞는가?”가 더 중요하기 때문입니다.
---
## 4. Slogs MCP 연결하기
LLM Wiki를 Agent가 사용하려면 Slogs MCP 연결이 필요합니다. Slogs에서는 HTTP MCP 엔드포인트를 제공합니다.
```text
https://slogs.dev/mcp
```
Slogs 설정 페이지에서 MCP 토큰을 만들 수 있습니다.
경로는 다음과 같습니다.
```text
/me/settings
```
설정 페이지에는 다음 영역이 있습니다.
- Slogs MCP 연결
- Endpoint 복사
- 설정 복사
- Slogs MCP 토큰 생성
- 생성된 토큰 복사
- 기존 토큰 목록
- 토큰 폐기
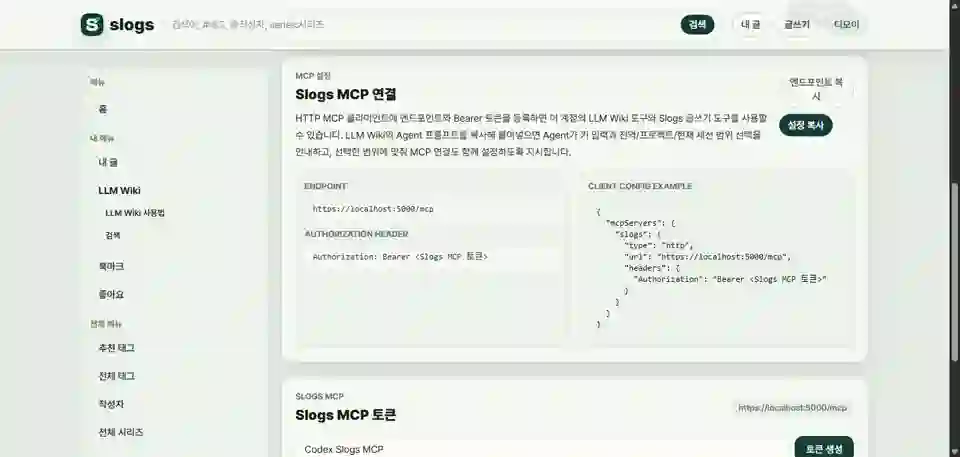
_설정 화면에서는 MCP endpoint와 토큰 생성/복사 흐름을 확인할 수 있습니다. 예시에는 실제 토큰 값이 아니라 placeholder만 사용합니다._
MCP 클라이언트 설정은 대략 이런 형태입니다.
```json
{
"mcpServers": {
"slogs": {
"type": "http",
"url": "https://slogs.dev/mcp",
"headers": {
"Authorization": "Bearer "
}
}
}
}
```
주의할 점은 토큰 값 자체를 문서, 로그, 프롬프트, LLM Wiki, 공개 글에 남기면 안 된다는 것입니다. Agent가 안전한 비밀 저장소나 환경 변수를 지원하면 그쪽을 우선 사용해야 합니다. 평문 설정 파일에만 넣을 수 있는 Agent라면 사용자가 그 사실을 알고 선택해야 합니다.
---
## 5. Agent 프롬프트를 적용하는 방법
Slogs LLM Wiki는 특정 Agent에만 묶여 있지 않습니다. Codex, Claude, GitHub Copilot, Cursor, Windsurf, Antigravity 등 MCP 또는 지속 지침을 지원하는 환경에 적용할 수 있습니다.
핵심 흐름은 다음과 같습니다.
1. Slogs에 로그인한다.
2. `/me/settings`에서 Slogs MCP 토큰을 만든다.
3. `/me/llm-wiki`에서 한국어 또는 English 프롬프트를 복사한다.
4. Agent의 지속 지침 위치에 프롬프트를 넣는다.
5. 같은 범위의 MCP 설정에 `https://slogs.dev/mcp`와 Bearer 토큰을 등록한다.
6. 새 세션에서 `llm_wiki_*` 도구가 보이는지 확인한다.
7. 도구가 보이면 `llm_wiki_instructions`로 연결과 정책을 확인한다.
적용 범위는 보통 세 가지 중 하나입니다.
- 전역: 모든 프로젝트에서 Slogs LLM Wiki를 기본 장기 기억으로 사용한다.
- 현재 프로젝트: 특정 repository/workspace에서만 사용한다.
- 현재 세션: 영구 파일을 수정하지 않고 이번 대화에서만 사용한다.
프롬프트는 Agent가 처음 설치할 때만 Slogs MCP 키와 적용 범위를 묻게 합니다. 이미 관리 블록이 설치된 새 세션에서는 키 요청과 범위 선택을 반복하지 않고, 버전 확인만 하도록 설계되어 있습니다.
---
## 6. MCP 도구를 언제 쓰는가
Slogs LLM Wiki의 MCP 도구는 목적이 다릅니다. 이름이 비슷해 보여도 쓰임새가 다릅니다.
| 도구 | 용도 | 주로 쓰는 순간 |
| ----------------------- | ------------------------------------------ | ------------------------------------------------ |
| `llm_wiki_instructions` | Slogs MCP/LLM Wiki 사용 정책 확인 | 세션 시작 후 연결 확인, 저장 전 정책 확인 |
| `llm_wiki_search` | 낮은 비용의 후보 검색 | 넓은 주제, 후보 선별, 카테고리 필터링 |
| `llm_wiki_recall` | 답변/구현에 바로 적용할 압축 컨텍스트 회상 | 이전 결정, 선호, 프로젝트 맥락을 바로 써야 할 때 |
| `llm_wiki_read` | 특정 항목 전체 읽기 | Raw Provenance나 전체 원문 확인 필요 시 |
| `llm_wiki_capture` | 저장 후보 점검과 관련 항목 찾기 | 기억을 저장하기 전 |
| `llm_wiki_find_related` | 관련 항목 검색 | 저장 전 중복 확인 |
| `llm_wiki_remember` | 새 기억 생성 | 관련 항목이 없고 장기 가치가 명확할 때 |
| `llm_wiki_merge` | 기존 기억에 새 정보를 병합 | 같은 주제의 기억을 보강할 때 |
| `llm_wiki_update` | 기존 기억을 교정된 문구로 교체 | 잘못된 기억을 바로잡을 때 |
| `llm_wiki_recent` | 최근 기억 확인 | 최근 작업 맥락을 훑을 때 |
| `llm_wiki_categories` | 카테고리 구조 확인 | categoryPath 분포를 볼 때 |
| `llm_wiki_llms_txt` | llms.txt 스타일 인덱스 확인 | Agent가 전체 Wiki 윤곽을 작게 파악할 때 |
가장 자주 헷갈리는 것은 `search`와 `recall`입니다.
### search
`search`는 후보 선별용입니다. 제목, 요약, 태그, 관련도, categoryPath 정도만 보고 “무엇을 더 읽을지” 고르는 데 적합합니다.
이럴 때 씁니다.
- 주제가 넓다.
- 어떤 항목이 있는지 모른다.
- categoryPath로 좁혀 보고 싶다.
- 결과가 엉뚱한지 가볍게 확인하고 싶다.
- 전체 원문까지는 아직 필요 없다.
예시 상황:
```text
사용자: Slogs 배포 정책 기억나?
Agent: 먼저 slogs/deployment 관련 search로 후보를 찾고, 필요한 항목만 read한다.
```
### recall
`recall`은 바로 적용할 압축 컨텍스트입니다. 검색 결과 목록보다 더 많은 맥락을 반환하므로 limit을 작게 유지하는 것이 좋습니다.
이럴 때 씁니다.
- 사용자가 “이어서 해줘”라고 했다.
- 이전 선호나 결정이 바로 작업에 영향을 준다.
- 답변에 적용해야 할 프로젝트 규칙이 있을 수 있다.
- 구현 전에 사용자 판단 기준을 확인해야 한다.
예시 상황:
```text
사용자: 서버에 반영해줘.
Agent: Slogs 배포 선호를 recall해서 일반 배포는 -WasmAot 없이 scripts/Deploy-Slogs.ps1를 써야 한다는 점을 적용한다.
```
### read
`read`는 전체 항목을 확인할 때 씁니다. 특히 Raw Provenance가 필요하면 `read`가 필요합니다.
이럴 때 씁니다.
- 기억을 merge/update하기 전에 기존 내용을 정확히 확인한다.
- 현재 요약이 원문과 맞는지 검증한다.
- 검색 결과 요약만으로는 충분하지 않다.
- 항목의 slug나 id를 알고 있다.
### capture와 find_related
새 기억을 만들기 전에는 반드시 관련 항목을 먼저 찾아야 합니다. 같은 기억을 여러 개로 쪼개 저장하면 검색 품질이 떨어지고, Agent가 서로 다른 기억을 다르게 해석할 수 있습니다.
`capture`는 저장 후보를 평가하면서 관련 항목을 찾아 줍니다. `find_related`는 더 직접적인 관련 항목 검색입니다.
좋은 흐름은 다음과 같습니다.
```text
1. llm_wiki_instructions로 저장 정책 확인
2. llm_wiki_capture 또는 llm_wiki_find_related로 관련 항목 확인
3. 관련 항목이 있으면 llm_wiki_read
4. 기존 기억과 새 정보를 합친 최종 문구 작성
5. llm_wiki_merge 또는 llm_wiki_update
6. 관련 항목이 없을 때만 llm_wiki_remember
```
### remember
`remember`는 새 기억을 만드는 도구입니다. 관련 항목이 없고, 장기 가치가 있을 때만 사용합니다.
좋은 remember 대상은 다음과 같습니다.
- 사용자가 정정한 용어
- 반복될 워크플로
- 프로젝트 운영 규칙
- 검증된 원인과 해결책
- 다음 세션에서 이어받아야 할 재시작 지점
- 코드만 보고는 알 수 없는 전제조건
- 나중에 runbook으로 바꿀 수 있는 명령 흐름
나쁜 remember 대상은 다음과 같습니다.
- “방금 빌드 중” 같은 중간 상태
- 임시 로그 전문
- 토큰 값
- 비밀번호
- 한 번 쓰고 버릴 파일 경로
- 검증되지 않은 추측
### merge와 update
`merge`는 기존 기억을 보강할 때 씁니다. 기존 내용이 맞고 새 정보가 추가되는 상황입니다.
예시:
```text
기존 기억: Slogs 일반 배포는 AOT 없이 한다.
새 정보: 20260624112752 릴리스도 scripts/Deploy-Slogs.ps1로 배포했고, 프로덕션 200을 확인했다.
처리: 기존 배포 정책은 유지하고, 배포 기록은 별도 release 항목 또는 관련 항목에 merge한다.
```
`update`는 기존 기억이 틀렸거나 표현을 교정해야 할 때 씁니다.
예시:
```text
기존 기억: LLM Wiki 검색과 사용법은 같은 페이지의 hash section이다.
새 사실: 이제 /me/llm-wiki와 /me/llm-wiki/search로 완전히 분리되었다.
처리: 기존 UI 기억을 update 또는 merge하여 오래된 설명이 남지 않게 한다.
```
---
## 7. Retrieval Diagnostics 읽는 법
Slogs MCP의 검색/회상 응답에는 Retrieval Diagnostics가 붙습니다. 이것은 단순 부가 정보가 아니라 검색 품질을 판단하는 신호입니다.
주요 항목은 다음과 같습니다.
- tool
- responseMode
- query
- results
- requestedLimit
- effectiveLimit
- categoryPath
- minRelevancePercent
- elapsedMs
Agent는 이 값을 보고 다음을 판단해야 합니다.
- 결과가 너무 많거나 적지 않은가?
- top result가 요청과 맞는가?
- categoryPath가 너무 넓거나 좁지 않은가?
- minRelevancePercent 때문에 필요한 항목이 빠지지 않았는가?
- elapsedMs가 비정상적으로 느리지 않은가?
- 응답이 너무 커서 오히려 작업을 방해하지 않는가?
검색 결과가 만족스럽지 않으면 그냥 진행하지 말고 조회를 다시 조정해야 합니다.
조정 방법은 다음과 같습니다.
- query를 더 구체적으로 쓴다.
- categoryPath를 지정한다.
- limit을 줄인다.
- minRelevancePercent를 올려 잡음을 줄인다.
- 반대로 필요한 항목이 빠지면 minRelevancePercent를 낮춘다.
- search로 후보를 찾은 뒤 필요한 항목만 read한다.
예를 들어 “배포”라는 검색어만 쓰면 배포 정책, 릴리스 기록, Caddy, Docker, AOT, 이미지 업로드 배포 검증까지 섞일 수 있습니다. 이때는 다음처럼 좁히는 것이 좋습니다.
```text
query: Slogs deployment AOT opt-in preference scripts/Deploy-Slogs.ps1
categoryPath: slogs/deployment
limit: 3
```
---
## 8. GraphRAG는 어떻게 검색 품질을 높이는가
Slogs LLM Wiki는 단순 문자열 검색만 하지 않습니다. 제목, 태그, Source Prompt, Content, categoryPath를 함께 사용하고, 서버 로컬 EmbeddingGemma와 PostgreSQL pgvector, graph node 관계 점수를 결합합니다.
간단히 말하면 두 축을 함께 봅니다.
첫째, 의미 기반 검색입니다. 문장이 정확히 일치하지 않아도 비슷한 의미를 찾습니다. 예를 들어 “서버 반영”과 “배포”는 문자열은 다르지만 같은 작업 맥락으로 잡힐 수 있습니다.
둘째, graph node 기반 관계입니다. 제목 phrase, 태그, 핵심어, categoryPath 같은 구조적 신호를 사용합니다. 한국어 조사 차이도 graph token 정규화로 어느 정도 줄입니다.
관련도 퍼센트는 통계적 확률이 아닙니다. “이 기억이 현재 query와 얼마나 관련 있어 보이는가”를 나타내는 GraphRAG 관련도 점수입니다. 따라서 100%라고 해서 무조건 정답이라는 뜻은 아닙니다. top result의 제목, 요약, 태그, categoryPath, 필요하면 Raw Provenance까지 보고 판단해야 합니다.
---
## 9. categoryPath를 잘 설계하는 법
LLM Wiki가 쌓일수록 categoryPath가 중요해집니다. 좋은 categoryPath는 검색 범위를 좁히고, 기억을 읽는 사람에게 위치를 알려 줍니다.
권장 패턴은 다음과 같습니다.
```text
project/domain/topic
project/feature/decision
preference/domain/project
agent/tool/topic
```
Slogs에서 쓸 수 있는 예시는 다음과 같습니다.
```text
slogs/llm-wiki/graphrag
slogs/llm-wiki/ui
slogs/deployment/releases
slogs/ui/profile-hero
slogs/post-images/lifecycle
slogs/admin/user-usage
codex/mcp/slogs
preference/memory/slogs
```
좋지 않은 예시는 다음과 같습니다.
```text
general
notes
misc
project
memory
```
이런 경로는 나중에 검색을 좁힐 수 없습니다. “어느 프로젝트의 어떤 영역에 관한 기억인가?”가 드러나야 합니다.
또한 categoryPath는 태그와 다릅니다. 태그는 보조 라벨입니다. categoryPath는 기억이 놓이는 구조입니다.
예를 들어 다음 항목을 보겠습니다.
```text
categoryPath: slogs/deployment/releases
tags: slogs, deployment, non-aot, profile-hero, llm-wiki
```
categoryPath는 “Slogs 배포 릴리스 기록”이라는 위치를 나타내고, tags는 검색 보조 신호를 제공합니다.
---
## 10. 저장할지 말지 판단하는 기준
Slogs LLM Wiki를 잘 쓰려면 아무거나 저장하지 않는 것이 중요합니다. 기억은 많이 쌓이면 좋지만, 잡음이 많아지면 검색 품질이 떨어집니다.
저장할 만한 정보는 다음 질문을 통과해야 합니다.
1. 다음 세션에서도 필요할 가능성이 있는가?
2. 다른 Agent가 알아야 할 판단 기준인가?
3. 사용자가 명시적으로 선호나 원칙을 정정했는가?
4. 같은 문제가 반복될 때 원인 추적에 도움이 되는가?
5. 코드만 읽어서는 알 수 없는 전제조건인가?
6. 나중에 자동화나 runbook으로 바꿀 만한 흐름인가?
7. 민감 정보 없이도 의미 있게 저장할 수 있는가?
저장하지 말아야 할 정보는 다음과 같습니다.
- 토큰 값
- 비밀번호
- OAuth secret
- 개인 식별 정보 중 작업과 무관한 것
- 한 번만 쓰는 인증 코드
- 임시 오류 로그 전문
- “빌드 실행 중” 같은 진행상황
- 아직 검증하지 않은 가설
- 현재 코드에서 바로 확인 가능한 단순 함수명
애매하면 보수적으로 저장하지 않는 것이 낫습니다. 단, 사용자가 명시적으로 “기억해둬”라고 말했고 민감하지 않다면 저장 후보로 다뤄야 합니다.
---
## 11. Agent가 실제로 따라야 할 기본 흐름
Slogs LLM Wiki를 연결한 Agent의 기본 동작은 다음에 가깝습니다.
### 요청을 받았을 때
1. 이 요청이 이전 결정, 선호, 판단 기준, 프로젝트 맥락과 관련되는지 판단한다.
2. 관련될 수 있으면 Slogs LLM Wiki를 먼저 조회한다.
3. 넓은 주제는 `search`, 바로 적용할 맥락은 `recall`을 쓴다.
4. Retrieval Diagnostics를 확인한다.
5. 필요한 항목은 `read`로 원문과 Raw Provenance를 확인한다.
6. 조회 결과를 바탕으로 작업한다.
### 작업을 마치기 전
1. 장기 기억으로 남길 만한 암묵지가 생겼는지 점검한다.
2. 저장 전 `llm_wiki_instructions`를 확인한다.
3. `capture` 또는 `find_related`로 관련 기억을 찾는다.
4. 관련 항목이 있으면 `read` 후 `merge` 또는 `update`한다.
5. 관련 항목이 없으면 `remember`한다.
6. categoryPath를 명확히 지정한다.
7. 민감 정보와 임시 로그는 저장하지 않는다.
이 흐름을 지키면 기억이 중복으로 흩어지는 문제를 줄일 수 있습니다.
---
## 12. 실전 예시: 배포 요청
사용자가 이렇게 말합니다.
```text
서버에 반영해줘
```
이 요청은 단순 명령처럼 보이지만, 프로젝트별 배포 정책이 관련됩니다. Agent는 먼저 Slogs LLM Wiki를 조회해야 합니다.
좋은 흐름은 다음과 같습니다.
```text
1. recall: Slogs deployment slogs.dev deploy script non-AOT policy
2. 배포 정책 확인: 일반 배포는 scripts/Deploy-Slogs.ps1, -WasmAot 없음
3. 로컬 변경 상태 확인
4. 필요한 검증 실행
5. scripts/Deploy-Slogs.ps1 실행
6. https://slogs.dev/ 200 확인
7. 핵심 라우트 확인
8. 배포 릴리스 ID와 검증 결과를 저장 후보로 점검
```
이때 LLM Wiki가 없으면 Agent는 이전에 사용자가 “AOT는 명시 요청 때만”이라고 정정한 사실을 놓칠 수 있습니다. 기억이 있으면 같은 실수를 반복하지 않습니다.
---
## 13. 실전 예시: UI 문제 수정
사용자가 스크린샷과 함께 말합니다.
```text
흰 배경에는 잘 보이지만 어두운 배경에는 어두운 글자가 잘 안보여!
```
Agent는 이 요청을 단순 CSS 문제로만 보면 안 됩니다. 이전 UI 규칙, 프로젝트의 디자인 기준, 검증 산출물 위치 같은 맥락이 관련될 수 있습니다.
좋은 흐름은 다음과 같습니다.
```text
1. recall/search로 Slogs UI 관련 기억 확인
2. 실제 컴포넌트와 CSS 검색
3. 체크리스트 등록
4. 어두운 배경 위에 어두운 텍스트가 겹치는 원인 확인
5. CSS 수정
6. 빌드와 테스트
7. 데스크톱/모바일 캡처 저장
8. 재발 방지 기준을 Slogs LLM Wiki에 저장
```
이렇게 저장된 기억은 다음 UI 수정 때 도움이 됩니다. 예를 들어 `slogs/ui/profile-hero` categoryPath에 “어두운 커버 위에는 이름과 팔로워 액션의 어두운 텍스트가 겹치지 않아야 한다”는 기준이 남아 있으면, 다음 Agent가 같은 영역을 다시 건드릴 때 참고할 수 있습니다.
---
## 14. 실전 예시: 사용자가 용어를 정정할 때
사용자가 이렇게 말할 수 있습니다.
```text
그 표현 말고 앞으로는 이 용어로 불러줘.
```
이런 정보는 LLM Wiki에 저장할 가치가 큽니다. 용어는 답변 품질과 신뢰에 직접 영향을 줍니다.
좋은 처리 흐름은 다음과 같습니다.
```text
1. llm_wiki_instructions 확인
2. llm_wiki_capture로 관련 기억 확인
3. 기존 용어 기억이 있으면 read
4. 새 정정 내용을 반영해 merge 또는 update
5. 없으면 remember
6. categoryPath는 preference/terminology/... 또는 프로젝트별 경로 사용
```
주의할 점은 사용자의 민감한 개인정보를 불필요하게 저장하지 않는 것입니다. 용어 정정 자체가 작업 품질에 중요하고 민감하지 않을 때만 저장합니다.
---
## 15. 사람이 직접 검색할 때의 팁
Slogs 화면에서 LLM Wiki를 검색할 때는 다음 순서가 좋습니다.
1. 먼저 검색어를 짧게 넣어 본다.
2. 결과가 많으면 categoryPath 필터를 선택한다.
3. 카드의 제목과 요약을 본다.
4. 관련도 퍼센트를 참고하되 맹신하지 않는다.
5. 상세 모달을 열어 Source Prompt와 Content를 읽는다.
6. 중요한 항목은 Raw Provenance까지 확인한다.
검색어는 자연어로 써도 됩니다.
예시:
```text
Slogs 배포 AOT 정책
LLM Wiki 검색 페이지 분리
프로필 히어로 어두운 배경 대비
MCP 이미지 업로드 삭제 수명주기
Codex 전역 Slogs MCP 설정
```
categoryPath를 알고 있으면 더 좋습니다.
```text
slogs/deployment
slogs/llm-wiki
slogs/ui
codex/mcp/slogs
preference/memory/slogs
```
---
## 16. Agent에게 요청할 때의 좋은 표현
Slogs LLM Wiki가 연결되어 있다면 사용자는 다음처럼 말할 수 있습니다.
```text
이전 결정 기준을 확인하고 진행해줘.
```
```text
Slogs Wiki 먼저 보고 이 작업 이어서 해줘.
```
```text
이건 앞으로도 기억해둬.
```
```text
지난번 배포 방식과 같은 기준으로 서버에 반영해줘.
```
```text
이 표현은 앞으로 이 용어로 써줘.
```
```text
관련 기억 검색해서 현재 코드와 맞는지 확인해줘.
```
Agent는 이런 요청을 받으면 단순히 대화 문맥만 보지 않고 Slogs LLM Wiki를 조회해야 합니다.
---
## 17. 기억을 잘 병합하는 방법
LLM Wiki를 오래 쓰면 같은 주제의 기억이 계속 보강됩니다. 이때 새 항목을 무작정 만들면 나중에 검색 결과가 중복됩니다.
병합이 필요한 경우는 다음과 같습니다.
- 같은 프로젝트의 같은 기능에 대한 후속 구현
- 기존 운영 정책에 검증 결과가 추가됨
- 같은 오류의 재발 방지 규칙이 보강됨
- 기존 사용자 선호에 예외가 추가됨
- 같은 UI 영역에 새 디자인 기준이 추가됨
병합할 때는 기존 기억을 먼저 읽어야 합니다. 그런 다음 Agent가 최종 문구를 직접 작성해야 합니다. “기존 내용 + 새 내용”을 아무렇게나 이어 붙이는 것이 아니라, 현재 기준으로 읽히는 통합 기억을 만들어야 합니다.
좋은 merge 결과는 다음 조건을 만족합니다.
- 기존 핵심이 사라지지 않는다.
- 새 정보가 어디에 적용되는지 명확하다.
- 오래된 내용이 있으면 현재 상태에 맞게 정리된다.
- categoryPath가 더 명확해질 수 있으면 갱신한다.
- Raw Provenance는 보존된다.
---
## 18. 기억을 업데이트해야 하는 경우
`update`는 더 조심해서 써야 합니다. 기존 기억이 틀렸거나, 사용자가 명확히 정정했거나, 현재 정책이 바뀌었을 때 사용합니다.
예를 들어 기존 기억이 다음과 같다고 합시다.
```text
LLM Wiki 사용법과 검색은 /me/llm-wiki 한 페이지의 두 섹션이다.
```
그런데 현재 구현이 바뀌었습니다.
```text
/me/llm-wiki는 사용법과 Agent prompt 페이지이고, /me/llm-wiki/search는 검색과 읽기 페이지다.
```
이 경우 기존 기억을 그대로 두면 다음 Agent가 잘못된 링크를 안내할 수 있습니다. 따라서 update 또는 merge로 현재 상태를 반영해야 합니다.
---
## 19. 보안 원칙
Slogs LLM Wiki는 Agent가 조회할 수 있는 장기 기억입니다. 따라서 보안 기준을 강하게 잡아야 합니다.
절대 저장하지 말아야 할 것:
- Slogs MCP 토큰 값
- API 키
- 비밀번호
- OAuth client secret
- 일회용 인증 코드
- 개인 파일의 민감한 원문
- 로그에 포함된 secret
- 비공개 식별 정보 중 작업에 필요 없는 것
MCP 설정 예시를 문서화할 때도 실제 토큰을 쓰지 말고 placeholder를 사용해야 합니다.
```text
Authorization: Bearer
```
Agent가 브라우저나 파일에서 토큰을 보게 되더라도, 그것을 응답이나 LLM Wiki에 남기면 안 됩니다.
---
## 20. 운영자가 볼 수 있는 품질 신호
Slogs에는 관리자용 LLM Wiki MCP 품질 지표도 있습니다. 이 지표는 사용자의 기억 내용 원문을 저장하는 것이 아니라, metadata-only audit row를 기반으로 품질을 봅니다.
예를 들어 다음 신호를 볼 수 있습니다.
- 최근 MCP 호출 수
- recall/search 호출 수
- valid-result rate
- empty-result rate
- repeated-query rate
- 평균 응답 시간
- p95 응답 시간
- slow call 수
- mutation call 비율
- tool별 breakdown
이 지표는 “LLM Wiki가 실제로 도움이 되는가?”를 판단하는 데 유용합니다. 검색이 자주 빈 결과를 내거나, 반복 query가 많거나, 특정 도구가 느리다면 query 설계, categoryPath, 인덱싱, Agent 정책을 조정해야 합니다.
---
## 21. 좋은 LLM Wiki 운영 습관
마지막으로, Slogs LLM Wiki를 오래 쓰기 위한 습관을 정리합니다.
### 1. 작업 시작 전에 기억을 먼저 본다
프로젝트 맥락이 조금이라도 중요하면 먼저 조회합니다. 특히 배포, 사용자 선호, 반복 워크플로, 이전 오류는 기억을 먼저 보는 것이 안전합니다.
### 2. 저장은 적게, 하지만 중요한 것은 놓치지 않는다
모든 로그를 저장하지 않습니다. 대신 “다음 Agent가 이것을 몰라서 실수할 수 있는가?”를 기준으로 봅니다.
### 3. categoryPath를 성의 있게 정한다
나중에 검색 품질은 categoryPath의 영향을 많이 받습니다. `misc`에 넣는 순간 미래의 검색 비용이 커집니다.
### 4. merge/update를 두려워하지 않는다
좋은 Wiki는 항목 수가 많은 Wiki가 아니라, 같은 주제의 기억이 잘 통합된 Wiki입니다.
### 5. Raw Provenance를 확인한다
중요한 판단에는 원문 근거를 확인합니다. 기억은 요약될 수 있지만, 출처는 보존되어야 합니다.
### 6. Retrieval Diagnostics를 읽는다
검색 결과가 나왔다는 사실만으로 충분하지 않습니다. 결과 수, 관련도, elapsedMs, limit, categoryPath를 보고 검색이 건강한지 확인합니다.
### 7. Agent 정책을 최신으로 유지한다
프롬프트 전체를 매번 다시 붙여넣을 필요는 없습니다. version URL을 확인하고, 버전이 바뀌었을 때만 갱신합니다.
---
## 22. 빠른 시작 요약
처음 사용하는 사람은 아래 순서만 따라도 됩니다.
1. Slogs에 로그인합니다.
2. `/me/settings`에서 Slogs MCP 토큰을 생성합니다.
3. `/me/llm-wiki`에서 한국어 Agent 프롬프트를 복사합니다.
4. 사용하는 Agent의 전역 또는 프로젝트 지침에 프롬프트를 적용합니다.
5. MCP 설정에 `https://slogs.dev/mcp`와 Bearer 토큰을 등록합니다.
6. 새 세션에서 `llm_wiki_*` 도구가 보이는지 확인합니다.
7. Agent에게 “이전 결정이나 프로젝트 맥락이 관련되면 Slogs LLM Wiki를 먼저 조회해”라고 지시합니다.
8. Slogs 화면에서는 `/me/llm-wiki/search`에서 저장된 기억을 검색합니다.
9. 기억을 저장할 때는 먼저 관련 항목을 찾고, 중복이면 merge/update합니다.
10. 민감 정보와 임시 로그는 저장하지 않습니다.
---
## 마무리
Slogs LLM Wiki는 “AI가 알아서 다 기억한다”는 막연한 기능이 아닙니다. 오히려 반대에 가깝습니다. 무엇을 기억해야 하고, 무엇을 저장하지 말아야 하며, 저장된 기억이 어떤 원문 근거를 갖는지 명확히 관리하려는 도구입니다.
Agent를 오래 쓰다 보면 중요한 것은 모델의 순간적인 답변 능력만이 아닙니다. 반복되는 프로젝트 맥락, 사용자의 판단 기준, 검증된 운영 절차, 정정된 용어를 얼마나 일관되게 이어가느냐가 실제 작업 품질을 좌우합니다.
Slogs LLM Wiki는 그 일관성을 만들기 위한 개인 지식 기반입니다. 사람은 Slogs 화면에서 검색하고 검토할 수 있고, Agent는 MCP 도구를 통해 필요한 기억을 조회하고 저장할 수 있습니다. 이 둘이 함께 동작할 때, Slogs는 단순한 블로그를 넘어 Agent와 함께 쓰는 작업 기억 시스템이 됩니다.
---
# AI 음성 합성은 지금 어디까지 왔을까?
- Public log: https://slogs.dev/@dimohy/ai-%EC%9D%8C%EC%84%B1-%ED%95%A9%EC%84%B1%EC%9D%80-%EC%A7%80%EA%B8%88-%EC%96%B4%EB%94%94%EA%B9%8C%EC%A7%80-%EC%99%94%EC%9D%84%EA%B9%8C
- Markdown version: https://slogs.dev/@dimohy/ai-%EC%9D%8C%EC%84%B1-%ED%95%A9%EC%84%B1%EC%9D%80-%EC%A7%80%EA%B8%88-%EC%96%B4%EB%94%94%EA%B9%8C%EC%A7%80-%EC%99%94%EC%9D%84%EA%B9%8C.md
- Slogger home: @dimohy
- Published: 2026-06-22
- Updated: 2026-06-22
- Reading span: 14 minutes
- Tags: #ai, #tts, #lingomotion, #.net, #발표
- Log series: LingoMotion
- Representative image: https://slogs.dev/uploads/20260622104442699-01-cover-7dd92e9a5d0a4847bf0addee3b7ce463.png
## Summary
.NET Universe Busan 2606에서 다룬 TTS의 진화와 LingoMotion 제작 파이프라인을 발표 자료와 데모 결과를 바탕으로 정리했다.
## Knowledge-Log Body
2026년 6월 20일 부산 라운지J에서 열린 `.NET Universe: Busan Edition, 2606`에서 `AI를 이용한 TTS, 음성합성 + LingoMotion`이라는 주제로 50분 세션을 진행했다. 발표의 중심은 모델 이름을 나열하는 것이 아니라, 텍스트가 실제 음성이 되고 다시 영상 콘텐츠가 되기까지 어떤 데이터 흐름을 지나가는지 확인하는 것이었다.
TTS를 단순히 “글을 읽어 주는 기능”으로 보면 요즘 모델의 차이가 잘 보이지 않는다. 실제 제작에서는 입력 문장, 발음 보정, 청킹, 음색 조건, 보코더, 볼륨 정규화, 자막, 배경, BGM, 최종 MP4까지 모두 품질에 관여한다. 이번 발표는 그 흐름을 과거 방식부터 최근 생성형 음성 모델, 그리고 LingoMotion 데모까지 한 줄로 연결해 보여 주는 자리였다.
## 소리는 먼저 데이터가 된다
음성 합성을 이해하려면 먼저 소리를 숫자로 봐야 한다. 마이크로 들어온 파형은 샘플링을 거쳐 일정 간격의 숫자 배열이 되고, 모델은 그 숫자의 패턴을 학습한다. 과거 TTS는 사람이 설계한 발음 규칙과 음소 단위, 운율 파라미터를 조합해 소리를 만들었다. 이후 신경망 TTS는 텍스트에서 mel-spectrogram 같은 중간 표현을 예측하고, vocoder가 이를 다시 파형으로 바꾸는 방식으로 자연스러움을 크게 끌어올렸다.
이 흐름에서 중요한 점은 “모델 하나가 곧 제품”이 아니라는 것이다. 숫자, 발음, 시간 길이, 음색, 파형이 단계마다 다른 표현으로 바뀌며, 오류도 그 단계마다 다르게 나타난다. 숫자를 잘못 읽으면 전처리 문제이고, 말끝이 어색하면 운율이나 duration 문제이며, 금속성 잡음은 vocoder나 후처리 문제일 수 있다.
## 제로샷과 파인튜닝 사이
최근 TTS는 참조 음성 몇 초만으로 비슷한 목소리를 만드는 zero-shot 방식과, 특정 목소리를 안정적으로 유지하기 위해 데이터를 더 모아 조정하는 fine-tuning 방식으로 나뉜다. zero-shot은 실험과 데모에 빠르고, fine-tuning은 장기 채널처럼 반복 제작에서 같은 목소리를 유지해야 할 때 유리하다.
다만 zero-shot이 쉬워질수록 동의와 출처는 더 중요해진다. 기술적으로 가능하다는 것과 써도 된다는 것은 다른 문제다. 공개 콘텐츠에서 합성 음성을 쓴다면 허가받은 목소리인지, 합성 여부를 어떻게 표시할지, 데모 범위를 어디까지 둘지 함께 정해야 한다.
## LingoMotion은 모델 호출이 아니라 제작 파이프라인이다
발표 후반부에서는 LingoMotion을 실제 제작 파이프라인으로 설명했다. LingoMotion은 대본 하나를 입력받아 `narration.wav`, `subtitles.srt`, 배경 이미지, BGM, `manifest.json`, 최종 `final.mp4`까지 연결하는 .NET/C# 기반 CLI 도구다. 핵심은 “어떤 모델을 썼는가”보다 “어떤 중간 파일을 남기고 어디서 검수할 수 있는가”에 있다.
발표 자료의 한국어 음성 체인은 다음처럼 구성했다.
1. 대본을 짧은 청크로 나눈다.
2. Supertonic v3 ONNX C# 경로로 안정적인 source TTS를 만든다.
3. CosyVoice3 / RT 계열로 개인 음색 조건을 입힌다.
4. Qwen3-TTS 계열의 direct clone 또는 source ICL 보정 실험으로 표현력을 비교한다.
5. 청크를 결합하고 YouTube 기준에 맞춰 loudness를 정리한다.
이 구조는 긴 한국어 낭독에서 특히 중요하다. 긴 문장을 한 번에 모델에 넣으면 누락, 반복, 어색한 쉼이 생기기 쉽다. 반대로 청킹과 검수 지점을 잘 남기면 문제가 생긴 구간만 다시 만들고, 최종 영상 전체를 처음부터 재생성하지 않아도 된다.
## 데모는 실제 파일 기준으로 검증했다
데모 폴더에는 `script.txt`, `subtitles.srt`, `manifest.json`, `narration.wav` 같은 산출물이 남아 있다. 발표용 라이브 데모는 Supertonic ONNX C# 경로를 사용했고, 생성된 `narration.youtube.wav`는 YouTube 기준인 -14 LUFS에 맞춰 정규화했다. `subtitles.srt`에는 5개의 cue가 생성되어 실제 타임라인 검수에도 사용할 수 있었다.
음성 비교 자료에는 원본 목소리, Fish Speech, Supertonic, CosyVoice3, Qwen3, hybrid 경로가 함께 정리되어 있다. 비교 매니페스트 기준으로 WAV 파일은 151개, YouTube 정규화 파일은 32개였고, loudness 리포트는 target -14 LUFS, true peak -1.5, LRA 11 기준으로 맞췄다.
여기서 중요한 검수 기준은 manifest만 믿지 않는 것이다. 실제 `wav` 또는 `mp4`를 열어 길이, 볼륨, 발음, 호흡, 말끝, 잡음을 확인해야 한다. LingoMotion이 중간 파일을 남기는 이유도 이 때문이다.
## 발표의 결론
AI 음성 합성은 이제 “목소리를 만들 수 있느냐”의 단계는 넘어섰다. 실제 제작에서 더 큰 차이는 운영 가능한 체인을 갖추었는지에서 나온다. 텍스트를 어떻게 준비하는지, 음성을 어떻게 나누어 만들고 합치는지, 어떤 기준으로 정규화하는지, 자막과 영상 타임라인까지 어떻게 이어 붙이는지가 품질과 재현성을 결정한다.
그래서 LingoMotion의 방향은 모델 래퍼가 아니라 제작 그래프다. 한 번 만든 결과를 설명하고, 검수하고, 필요한 구간만 다시 만들 수 있어야 반복 제작이 가능하다. 이번 발표는 그 관점을 TTS의 역사와 최신 모델 비교, 그리고 실제 데모 산출물로 연결해 보여 준 세션이었다.
---
# Slogs 사용법
- Public log: https://slogs.dev/@dimohy/slogs
- Markdown version: https://slogs.dev/@dimohy/slogs.md
- Slogger home: @dimohy
- Published: 2026-06-18
- Updated: 2026-06-29
- Reading span: 9 minutes
- Tags: #slogs, #guide, #mcp, #markdown, #getting-started
- Log series: slogs 사용 가이드
- Representative image: https://slogs.dev/uploads/slogs-usage-cover-20260619.png
## Summary
Slogs에서 Markdown 글을 작성하고 태그/시리즈로 정리하며, MCP로 임시저장·수정·게시하는 기본 흐름을 안내합니다.
## Knowledge-Log Body
# Slogs 사용법
Slogs는 Markdown으로 글을 쓰고, 태그와 시리즈로 정리하고, 필요하면 MCP를 통해 LLM Agent에서 바로 게시할 수 있는 블로그 서비스입니다. 이 글은 처음 Slogs를 사용할 때 알아두면 좋은 흐름을 짧게 정리합니다.
## 1. 계정으로 로그인하기
오른쪽 상단 계정 메뉴에서 Google 계정으로 로그인합니다. 로그인하면 내 홈, 글쓰기, 설정, MCP 토큰 발행 같은 개인 기능을 사용할 수 있습니다.
프로필 이름, 이메일, 소개, 이미지는 설정에서 수정할 수 있습니다. Google 로그인으로 기본값이 들어오더라도 이후에는 프로필에서 직접 바꾼 값을 우선합니다.
## 2. Markdown으로 글 작성하기
상단의 `글쓰기`에서 새 글을 작성합니다. 본문은 Markdown을 사용합니다.
```markdown
# 제목
본문을 Markdown으로 작성합니다.
- 목록
- 코드 블록
- 이미지
```
이미지는 편집기에 붙여넣거나 끌어다 놓으면 업로드됩니다. 본문 첫 이미지는 카드와 목록에서 대표 이미지처럼 활용될 수 있고, 별도의 대표 이미지가 지정된 경우에는 그 이미지가 우선 사용됩니다.
## 3. 태그와 시리즈로 정리하기
글에는 태그를 붙여 검색과 탐색이 쉬워지도록 할 수 있습니다. 비슷한 주제의 글은 시리즈로 묶으면 작성자 페이지와 사이드 메뉴에서 더 자연스럽게 이어집니다.
추천 방식은 간단합니다.
- 태그는 글의 핵심 주제를 2~5개 정도로 둡니다.
- 시리즈는 연속 글이나 같은 프로젝트 글에만 사용합니다.
- 제목과 요약은 목록에서 바로 이해되도록 짧고 명확하게 씁니다.
## 4. 내 페이지에서 관리하기
내 홈에서는 내가 쓴 글, 북마크, 좋아요, LLM Wiki 같은 개인 영역을 볼 수 있습니다. 왼쪽 메뉴는 현재 페이지의 맥락에 맞게 동작하고, 설정은 오른쪽 상단 계정 메뉴에서 접근합니다.
글이 아직 없으면 빈 상태만 표시됩니다. 새 글 작성은 상단 `글쓰기`에서 시작하면 됩니다.
## 5. MCP로 글 올리기
Slogs는 MCP를 지원합니다. 설정에서 Slogs MCP 토큰을 발행한 뒤 LLM Agent에 연결하면, Agent가 일반 Slogs 글을 임시저장, 수정, 게시할 수 있습니다.
예시 설정은 다음 형태입니다.
```json
{
"mcpServers": {
"slogs": {
"type": "http",
"url": "https://slogs.dev/mcp",
"headers": {
"Authorization": "Bearer "
}
}
}
}
```
MCP로 글을 올릴 때는 다음 도구를 사용합니다.
- `slogs_post_save_draft`: 임시저장
- `slogs_post_update`: 기존 글 수정
- `slogs_post_publish`: 공개 게시
- `slogs_post_read`: 게시글 읽기
중요한 점은 Slogs 게시글과 LLM Wiki가 분리되어 있다는 것입니다. `slogs_post_publish`는 공개 블로그 글을 만들고, LLM Wiki 도구는 개인 지식 저장소를 다룹니다.
## 6. LLM Wiki는 기억 저장소로 사용하기
LLM Wiki는 사용자의 LLM Agent가 나중에 다시 꺼내 쓰기 좋은 지식, 선호, 규칙을 저장하는 공간입니다. 일반 블로그 글처럼 공개되는 콘텐츠가 아니라 개인 MCP 흐름 안에서 활용되는 기억 저장소에 가깝습니다.
좋은 저장 대상은 다음과 같습니다.
- 프로젝트별 반복 규칙
- 배포 환경과 명령
- 개인 선호와 판단 기준
- 나중에 다시 이어가야 할 작업 맥락
비밀번호, 토큰, 비밀키 같은 민감 정보는 저장하지 않습니다.
## 마무리
Slogs의 기본 흐름은 단순합니다. 직접 글을 쓸 때는 `글쓰기`에서 Markdown으로 작성하고, Agent와 함께 작업할 때는 MCP로 임시저장과 게시를 맡기면 됩니다. 글은 Slogs에 남기고, 오래 기억해야 할 작업 규칙은 LLM Wiki에 남기는 방식으로 나누면 가장 깔끔하게 사용할 수 있습니다.